Dezentrale Datenarchitektur und wie Datenprodukte hineinpassen
Die dezentrale Datenarchitektur verändert den Umgang mit Daten, weil sie Datenprodukte zur wichtigsten Einheit des Nutzens macht. Dieser Beitrag geht der Rolle von Datenprodukten in der Architektur des Data Warehouse nach und stellt den klassischen Ansatz dem Modell des Data Mesh gegenüber. Um Datenprodukte und ihre Bedeutung besser zu fassen, lesen Sie am besten zuerst „Was sind Datenprodukte, und warum braucht Ihr Unternehmen sie?“. Das liefert hilfreichen Kontext für die Gedanken hier.
Was ist eine dezentrale Datenarchitektur?
Eine dezentrale Datenarchitektur ruht auf mehreren wesentlichen Bausteinen, die zusammen ein skalierbares und effizientes System für den Umgang mit Daten im ganzen Unternehmen ergeben. Im Kern stehen Domänen, die verschiedene Fachbereiche abbilden, etwa Marketing, Vertrieb oder Betrieb. Jede Domäne verantwortet ihre eigenen Daten und behandelt sie als Produkt, das Ansprüche an Qualität, Zugänglichkeit und Nutzbarkeit erfüllen muss. Dieser Zuschnitt nach Domänen sorgt dafür, dass die Datenverantwortung verteilt ist und am tatsächlichen fachlichen Bedarf hängt.
Die Datenprodukte selbst sind die Bausteine einer dezentralen Architektur. Jedes Datenprodukt enthält nicht nur die rohen Daten, sondern auch Metadaten und Wege für einen sicheren und einfachen Zugang. Metadaten sind entscheidend dafür, dass Datenprodukte auffindbar, verständlich und vertrauenswürdig sind. Dazu gehört die Dokumentation der Data Lineage sowie Hinweise zur Nutzung, damit Menschen im ganzen Unternehmen zuversichtlich mit den Daten arbeiten können (ausführlicher wird es im Abschnitt „Bestandteile eines Datenprodukts“).
Getragen wird dieser Aufbau von der Infrastruktur, dem technischen Rückgrat für Speicherung, Verarbeitung und Zugang zu Datenprodukten. Dazu zählen Cloud-Dienste, Rechenkapazität und Werkzeuge, um Zugriffskontrolle und Compliance durchzusetzen. Der Rahmen für die Governance sorgt dafür, dass die Domänen zwar eigenständig arbeiten, sich aber an gemeinsame Regeln und Richtlinien für Einheitlichkeit, Sicherheit und Compliance der Daten halten. Dieser Rahmen legt fest, wie Daten im Unternehmen zugänglich gemacht, geteilt und gepflegt werden.
Schließlich ist die Interoperabilität entscheidend für die Architektur, denn sie erlaubt es, Datenprodukte aus verschiedenen Domänen reibungslos zu verbinden. Einheitliche Formate, APIs und durchgängige Datenschemata sorgen dafür, dass Erkenntnisse frei und stimmig fließen, und fördern Zusammenarbeit und Neuerung im ganzen Unternehmen. In Dawiso steuern Sie Datenprodukte aus mehreren Domänen und von mehreren Plattformen an einem Ort.
Datenprodukte aus Sicht der Architektur des Data Warehouse
Das Data Warehouse liefert das technische Fundament für den Umgang mit Daten und richtet sich auf Speicherung, Verarbeitung und Verdichtung. Diese Schichten sichern zwar Datenqualität und Verlässlichkeit, sie liefern aber von sich aus weder den fachlichen Kontext noch die Wiederverwendbarkeit, die Datenprodukte in einem Data Mesh erreichen sollen.
Data Warehouses sind in der Regel in mehrere Schichten gegliedert. Der Aufbau in der Abbildung unten hat drei wesentliche Schichten: die Integrationsschicht (L0), die Speicherschicht (L1) und die Berichtsschicht (L2). Jede Schicht hat ihren eigenen Zweck in der Architektur des Data Warehouse.
Im Kern speichert das Data Warehouse rohe Daten, die oft in einer bestimmten Weise kodiert oder formatiert sind. Das unterscheidet sich grundlegend von der Architektur des „Data Mesh“, in der Datenprodukte auf einer höheren, fachlich ausgerichteten Schicht arbeiten. Das Data Mesh richtet sich darauf, wiederverwendbare, domänenspezifische Datenprodukte zu schaffen, und bildet damit gedanklich eine Schicht über dem Data Warehouse. Das Data Warehouse wiederum ist die unterste, tragende Schicht, auf der Speicherung und Verarbeitung der Daten umgesetzt werden.
L0 - Integrationsschicht: Das ist die Schicht der rohen Daten, in der Daten so abgelegt werden, wie sie aus den Quellsystemen kommen. Sie ist eine 1:1-Kopie der Daten, wie sie in den Ursprungssystemen vorliegen, sei es eine Liste von Transaktionen, Kunden oder E-Mail-Adressen. Diese Schicht ist das unveränderte Fundament für die weitere Verarbeitung und Umformung im Warehouse.
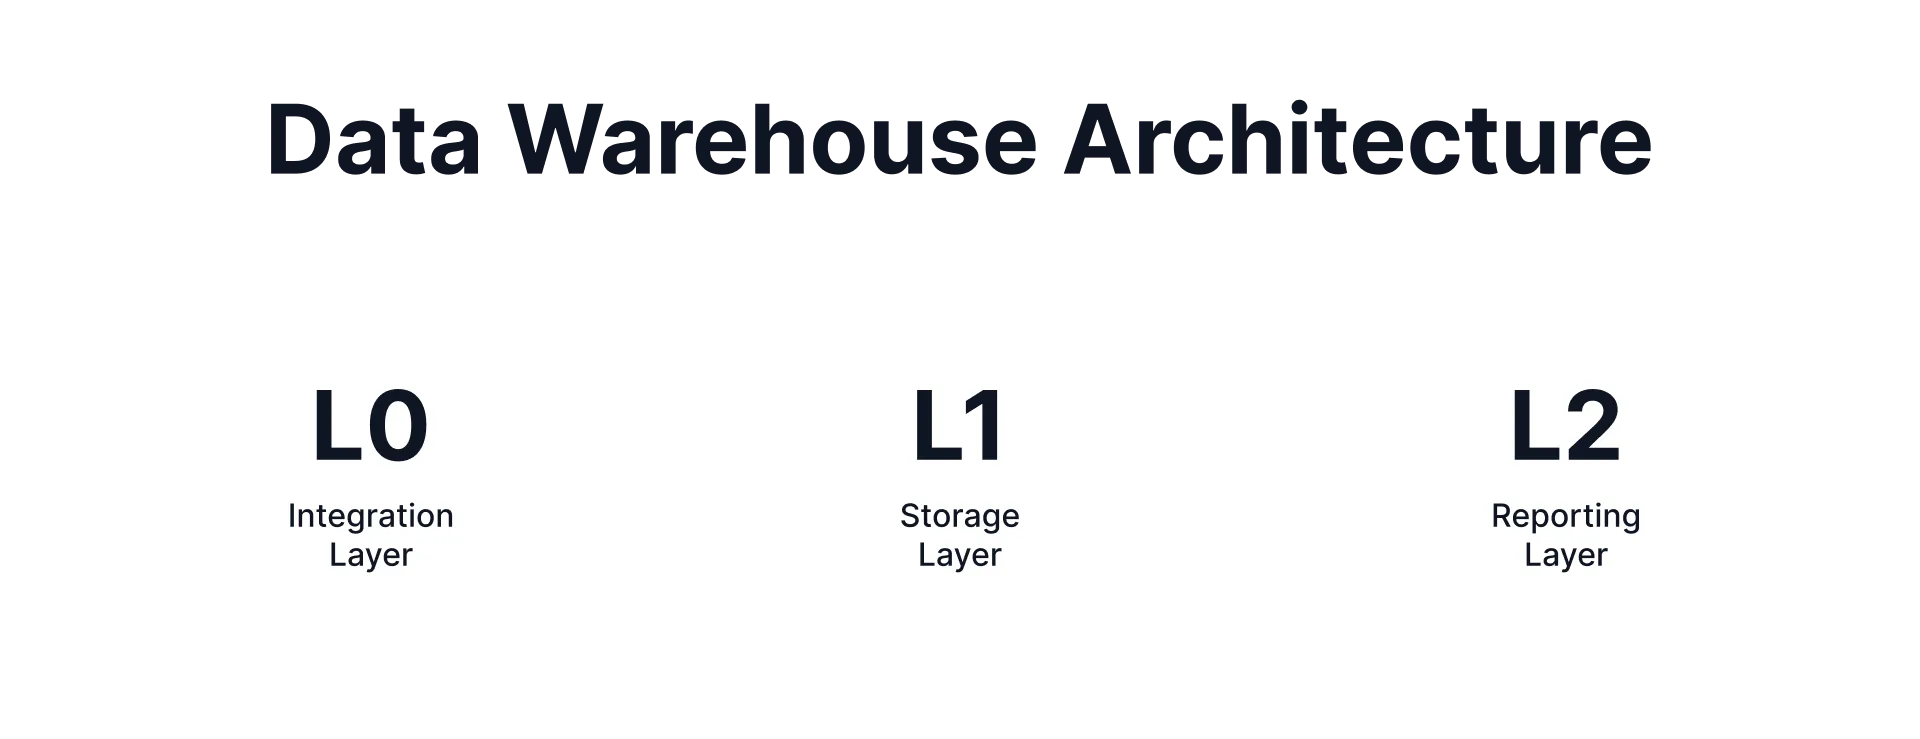
Sobald Daten im Warehouse angekommen sind, werden sie umgeformt und wandern nach L1, in die Speicherschicht. Diese Schicht hält verarbeitete und geordnete Daten und bildet den Kern des Data Warehouse. Anders als L0, das nach der Übernahme regelmäßig geleert wird, hält L1 die grundlegenden Datensätze, die das Rückgrat des Warehouse bilden.
In der Berichtsschicht (L2) werden Daten weiter verdichtet und ausgewertet, um Erkenntnisse zu gewinnen. Die Gesamtzahl der Kunden lässt sich hier etwa aus den Kundendaten in L1 errechnen. In L2 werden die Daten umsetzbar und für Berichte und Entscheidungen im Fachbereich zugänglich.
Nachdem wir die Architektur des Data Warehouse verstanden haben, stellt sich die Frage:
„Was fügt das Data Mesh dem hinzu?“
Das Data Mesh baut auf dem Fundament des Data Warehouse auf und richtet sich darauf, technische Tabellen in wiederverwendbare, domänenspezifische Datenprodukte zu fassen. Mit dieser fachlich ausgerichteten Schicht schlägt das Data Mesh die Brücke zwischen roher Speicherung und umsetzbaren Erkenntnissen und erlaubt den Teams, effizienter und eigenständiger zu arbeiten.
In einem Data Mesh verschiebt sich der Blick von Tabellen zu Datenprodukten, die zusammengehörige Tabellen zu einer Einheit bündeln. Das Beispiel in der Abbildung zeigt etwa Tabellen wie Customer Information, Customer Emails und Customer Transactions. Zusammen bilden sie ein einziges Datenprodukt „Customer“, und jedes Datenprodukt hat einen festgelegten Data Owner, der für Qualität und Pflege verantwortlich ist.
Ebenso könnte es in der Berichtsschicht (L2) ein Datenprodukt namens Customer Reporting geben, das mehrere Tabellen zum Errechnen und Ablegen von Kundenkennzahlen umfasst. Indem Daten als Produkte behandelt werden, schlägt der Ansatz des Data Mesh die Brücke zwischen rohen Daten und fachlichen Anwendungsfällen und schafft klarere Verantwortung, bessere Ordnung und bessere Nutzbarkeit im ganzen Unternehmen.
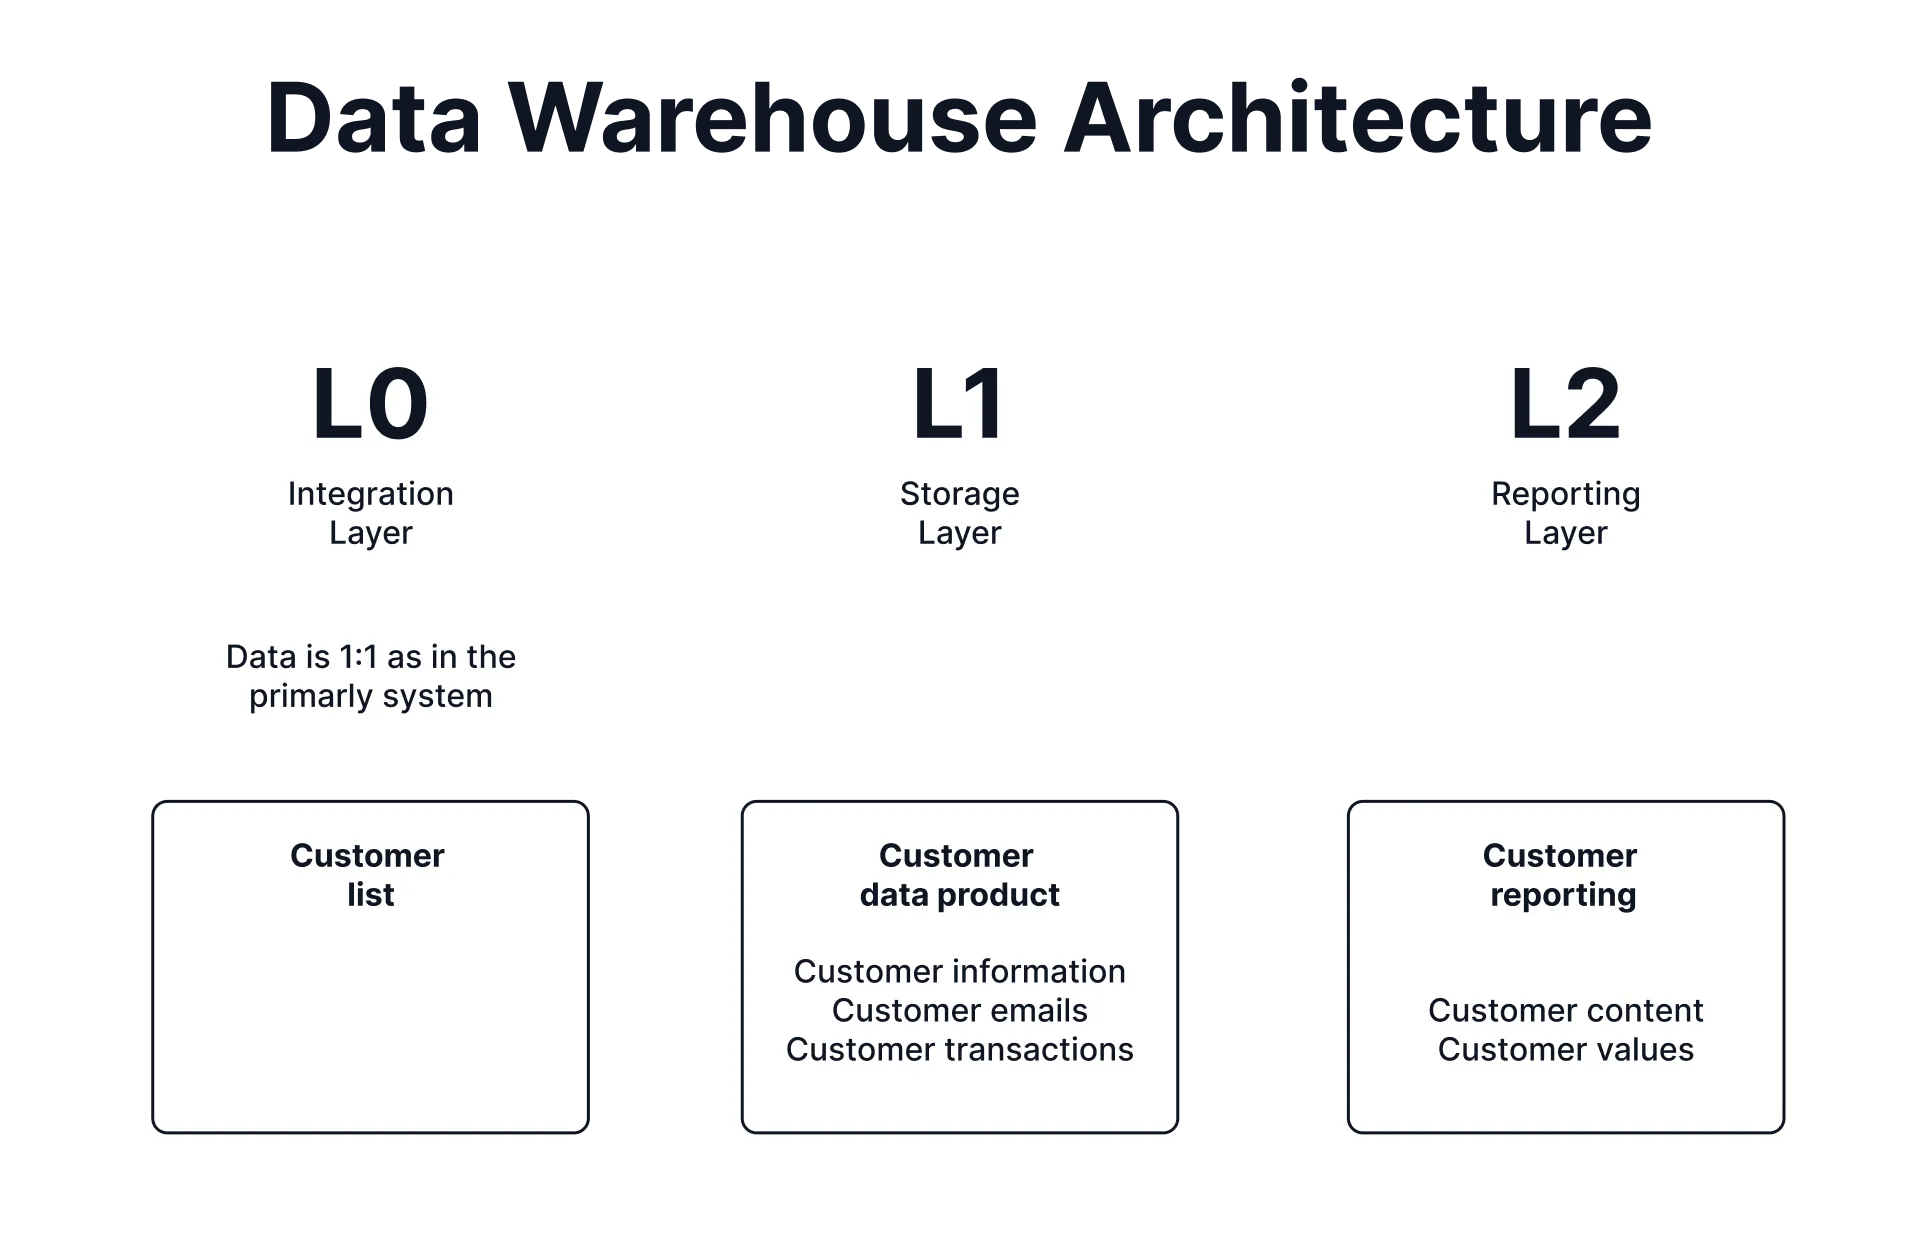
Die Tabellen in L1 und L2 unterscheiden sich deutlich in Inhalt und Zweck. In L1 enthalten die Tabellen rohe, unverarbeitete Daten, das Fundament des gesamten Data Warehouse. Hier sehen Sie ausführliche, historische Angaben zu Kunden, etwa wann sie ein Konto angelegt haben, ihre Kontobewegungen, Namensänderungen und weitere Änderungen im Zeitverlauf. Im Kern hält L1 die rohen, feinkörnigen Daten, die den Zustand der führenden Systeme abbilden.
Die Berichtsschicht (L2) richtet sich darauf, Daten zu umsetzbaren Erkenntnissen für Berichte und Auswertungen zu verdichten. Im Data Mesh gehen Datenprodukte jedoch einen Schritt weiter und führen zusammengehörige Erkenntnisse aus mehreren Schichten zu einer Einheit zusammen. Tabellen mit Kundenkennzahlen, Transaktionshistorie und verdichteten KPIs lassen sich etwa zu einem Datenprodukt „Customer Reporting“ bündeln, das leichter zu verstehen und für bestimmte fachliche Zwecke zu nutzen ist.
Damit diese Tabellen für Berichte richtig und einsatzbereit sind, braucht es Data Contracts. Ein Data Contract sichert zu, dass die Daten für die Berechnungen, etwa die rohen Kundendaten in L1, rechtzeitig vorliegen. Der Contract könnte etwa festlegen, dass das Datenprodukt „Customer“ täglich aktualisiert wird und um 23 Uhr bereitsteht. Diese Vereinbarung sorgt für Verlässlichkeit und Einheitlichkeit für alle nachgelagerten Nutzer, die sich für ihre Auswertungen auf L2 stützen (sie nutzen Customer Reporting, das Daten aus dem Datenprodukt „Customer“ bezieht).
Im Kern bezieht L2 seine Daten aus L1 und macht aus rohen Daten umsetzbare Erkenntnisse, während Data Contracts dafür sorgen, dass die Pipeline rund läuft und die Daten dann da sind, wenn sie gebraucht werden.
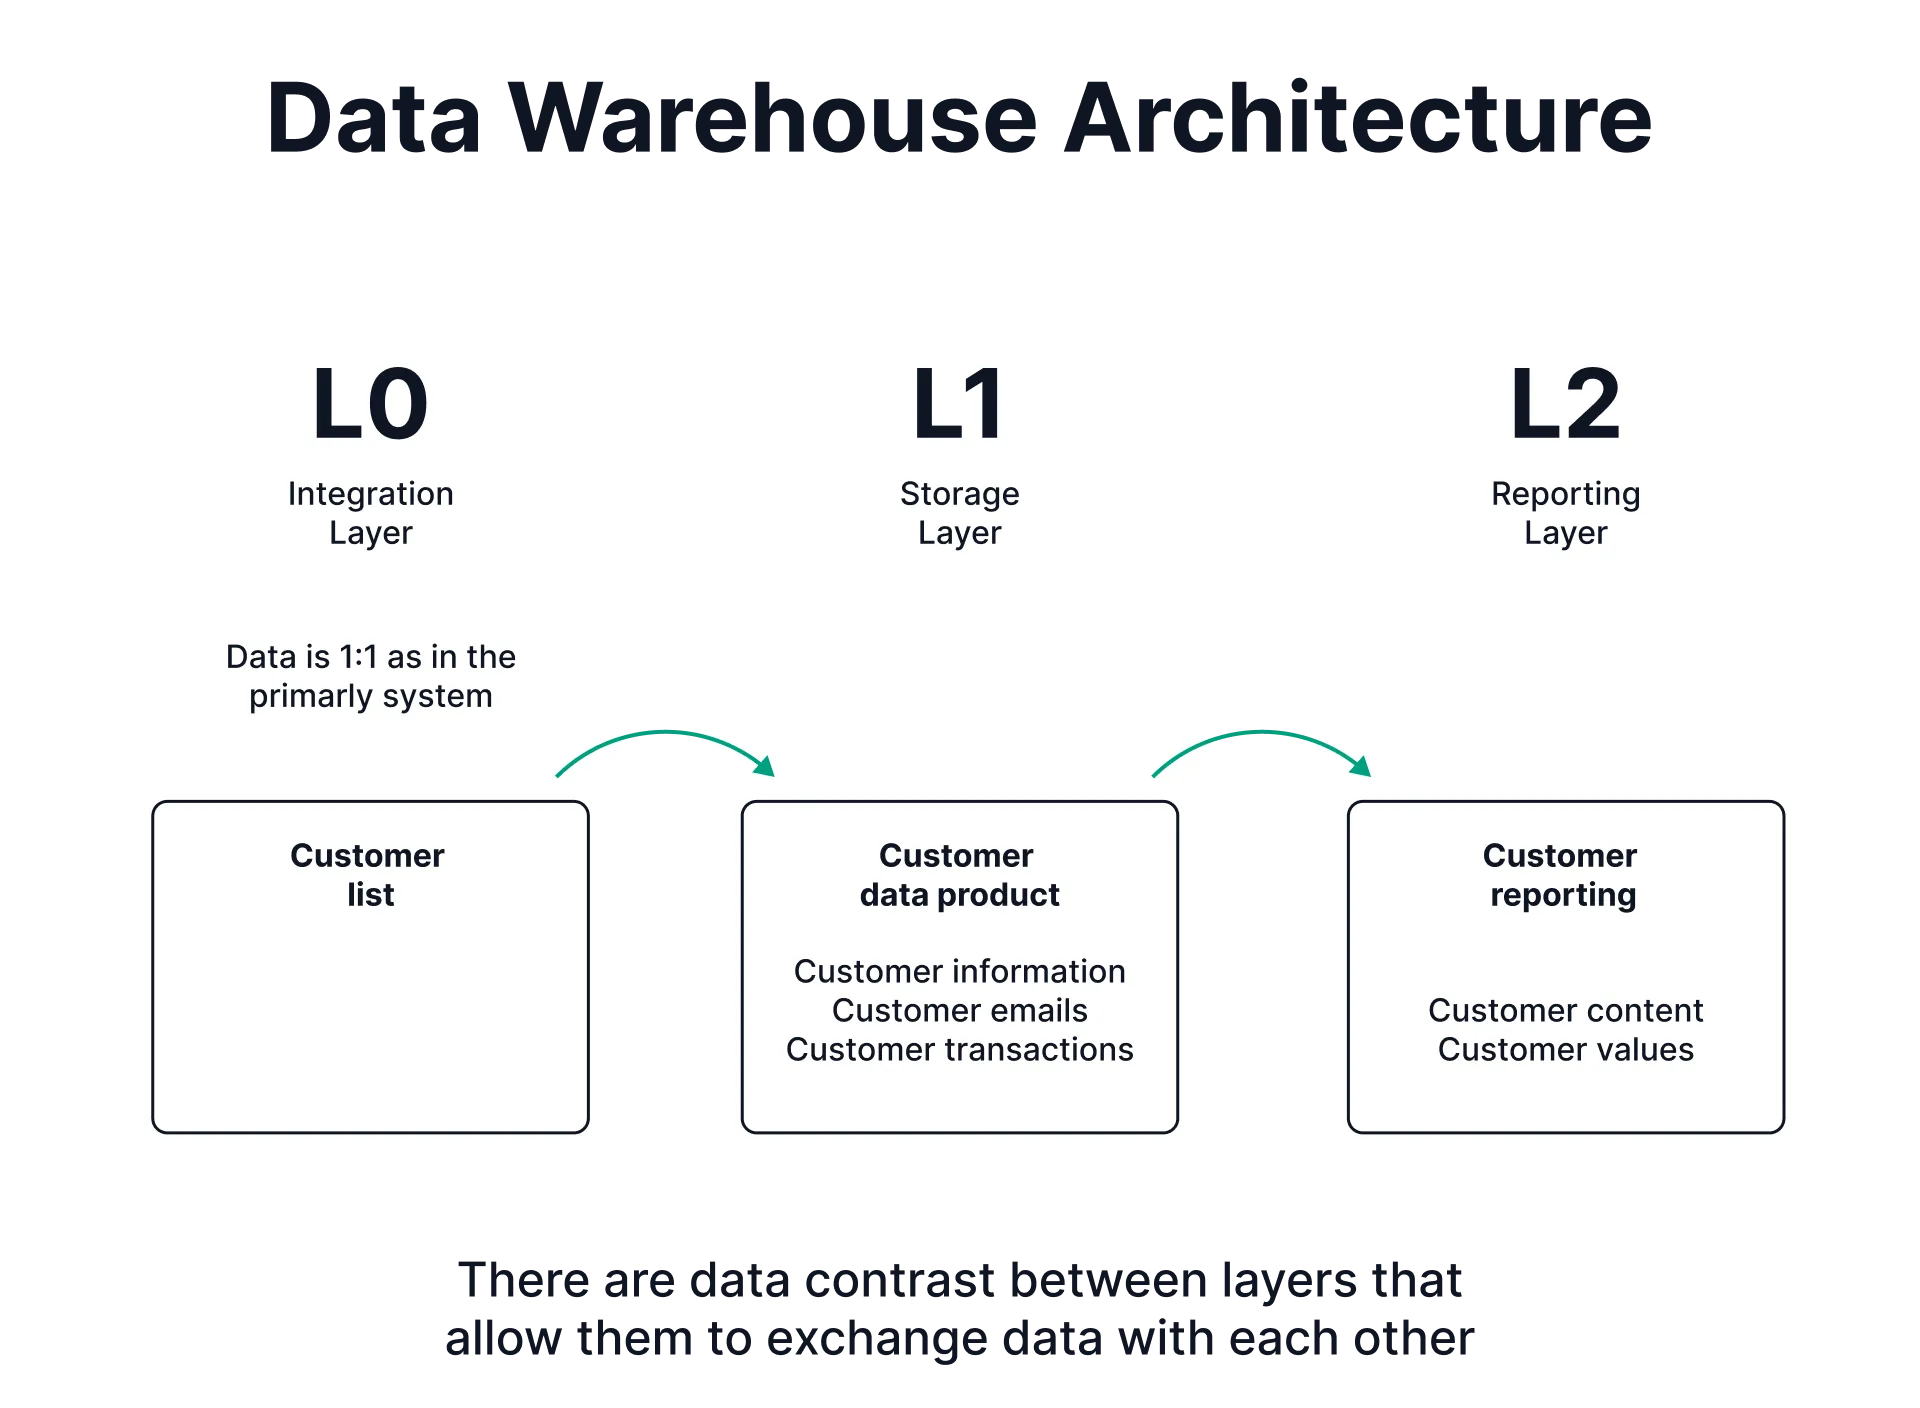
Der Data Contract wirkt als Vereinbarung zwischen L0 (Schicht der rohen Daten) und L1 (Schicht der verarbeiteten Daten) und sichert zu, dass das Datenprodukt in L0 die Daten rechtzeitig und in der nötigen Qualität bereitstellt, damit L1 sie wirksam verarbeiten und nutzen kann. Je nachdem, wie das Data Mesh umgesetzt ist, kann ein Datenprodukt mehrere Schichten umspannen oder in einer einzigen Schicht liegen.
Datenprodukte sind eine gedankliche fachliche Schicht, die zusammengehörige Tabellen über die technischen Schichten hinweg bündelt und ordnet, sodass sie für bestimmte fachliche Zwecke wiederverwendbar und zugänglich werden. Sie sind keine physischen Gebilde, die im Data Warehouse programmiert wären, sondern eine abstrakte Art, Daten zu ordnen und über sie nachzudenken. Werkzeuge wie Keboola können solche Datenprodukte sichtbar machen, was die Steuerung und die Arbeit damit erleichtert.
Stellen Sie sich Datenprodukte als sorgfältig gepackte Kisten vor, die alles für eine bestimmte fachliche Aufgabe enthalten: Kundenkennzahlen, Transaktionsdaten und Werkzeuge zur Auswertung, sauber verpackt und einsatzbereit.
Ein Bild für Datenprodukte: ein Laden für Laufschuhe
Stellen Sie sich einen Laden vor, der Laufschuhe verschiedener Marken verkauft, etwa Adidas, Nike und Puma. Der Laden stellt die Schuhe nicht selbst her, sondern bezieht sie von Lieferanten. Damit der Bestand stimmt, schließt der Laden Verträge mit diesen Lieferanten. Diese Verträge sichern regelmäßige Lieferungen der richtigen Schuhe zu, nach Bestellung oder nach vorab vereinbarten Bedingungen.
Ebenso haben die Lieferanten ihre eigenen Vereinbarungen mit den Herstellern, die Material beschaffen und die Schuhe fertigen. Weil diese Lieferkette gut geordnet ist, kann der Laden verlässlich Laufschuhe mehrerer Marken vorhalten und die Nachfrage bedienen.
Im Data Mesh wirken Data Contracts auf ganz ähnliche Weise. Sie sorgen dafür, dass ein Datenprodukt einem anderen die nötigen Daten rechtzeitig und in der nötigen Qualität liefert. Ein Contract könnte etwa zusichern, dass rohe Kundendaten aus L0 verarbeitet sind und bis zu einer bestimmten Uhrzeit für die Berichte in L1 bereitstehen. Umgesetzt werden solche Vereinbarungen über automatisierte Pipelines wie ETL, damit die Daten zwischen den Produkten gleichmäßig und verlässlich fließen.
Dieses Zusammenspiel aus Abstraktion (fachliche Schicht) und technischer Umsetzung sorgt dafür, dass das Data Mesh effizient arbeitet und zugleich dem fachlichen Bedarf dient.
Werkzeuge für das Data Mesh
Self-Service-Datenplattformen
Eine Self-Service-Datenplattform ist ein Eckpfeiler des Data Mesh. Sie versetzt die Domänenteams in die Lage, ihre Daten eigenständig zu steuern, und sichert zugleich Interoperabilität, Zugänglichkeit und Governance. Solche Plattformen straffen Aufgaben wie das Übernehmen, Umformen und Katalogisieren von Daten durch Automatisierung, sodass Data Producer und Data Consumer effizient arbeiten können, ohne stark von der IT abzuhängen. Eingängige Oberflächen, eingebaute Governance und Interoperabilität sorgen dafür, dass Datenprodukte zugänglich, einheitlich und sicher bleiben. Das stützt bessere Datenqualität, verringert Doppelarbeit und erlaubt es, mit dem Unternehmen mitzuwachsen.
Dawiso: Plattform für Data Governance und Katalog
Funktionen:
- Unterstützt die Entwicklung von Datenprodukten.
- Steuerung von Metadaten, Business Glossary und Verfolgung der Lineage.
- Werkzeuge für Zusammenarbeit, Transparenz und breiten Zugang zu Daten.
- Schwerpunkt auf Bedienbarkeit, Bezahlbarkeit und Zugänglichkeit für alle Domänen.
- Ermöglicht das Auffinden von Daten.
- Verankert Richtlinien der Data Governance.
Einsatz im Data Mesh: Dawiso kann als Bindeglied einer Self-Service-Datenplattform dienen und den Domänen helfen, ihre Datenprodukte im Sinne der Grundsätze des Data Mesh zu dokumentieren, zu finden und zu regeln.
Zusammenspiel mit anderen Plattformen
Unsere Plattform erlaubt es, Datenprodukte zu bestimmen, zu dokumentieren und in einer Art Marktplatz bereitzustellen. Zusammen mit Werkzeugen wie Keboola oder Confluent Kafka kann Dawiso etwa physische Datenflüsse automatisch aus den von Nutzern bestimmten Produkten erzeugen.
Diese Beweglichkeit trägt zentrale wie dezentrale Modelle und erlaubt Datenteams die Zusammenarbeit, während einzelne Fachbereiche wie Marketing oder Vertrieb die Verantwortung für ihre Daten übernehmen. Governance bleibt dabei eine entscheidende Schicht, denn ohne sie wird verteilte Datenarbeit schnell unübersichtlich.