Was ist Datenabgleich, und wie funktioniert er in der Praxis?
Aktualisiert · Veröffentlicht
Datenabgleich ist der Prozess, zwei Datensätze zu vergleichen, die übereinstimmen sollten, zu finden, wo sie es nicht tun, und den Unterschied aufzulösen. Drei recht verschiedene Aufgaben teilen sich den Namen: der finanzielle Abgleich zwischen Hauptbüchern und Kontoauszügen, der Abgleich von Pipelines, nachdem Daten verschoben oder migriert wurden, und der Abgleich von Stammdaten über doppelte Datensätze hinweg. Sie scheitern aus unterschiedlichen Gründen und werden von unterschiedlichen Menschen behoben, und deshalb stocken Gespräche über den Abgleich, wenn zwei Menschen Verschiedenes meinen. Und die Abweichungen, die jeden Monat wiederkommen, sind fast nie technisch.
Was ist Datenabgleich?
Datenabgleich ist die Praxis, Daten aus verschiedenen Systemen oder Quellen zu vergleichen, um Einheitlichkeit und Richtigkeit sicherzustellen. Dieser Prozess ist unverzichtbar für die Datenintegrität, denn er hilft, Abweichungen zwischen Datensätzen zu erkennen und zu korrigieren. Der Datenabgleich dient als Kontrollpunkt der Qualität und stellt sicher, dass nachgelagerte Analysen, Berichte und Entscheidungen auf einheitlichen, verlässlichen Daten beruhen.
Der Grund, warum es ihn gibt, ist unspektakulär. Dieselbe Tatsache wird an mehr als einer Stelle erfasst, diese Stellen widersprechen sich, und jemand muss festlegen, nach welcher Fassung gehandelt wird, bevor eine Entscheidung, eine Zahlung oder ein Bericht an die Aufsicht davon abhängt.
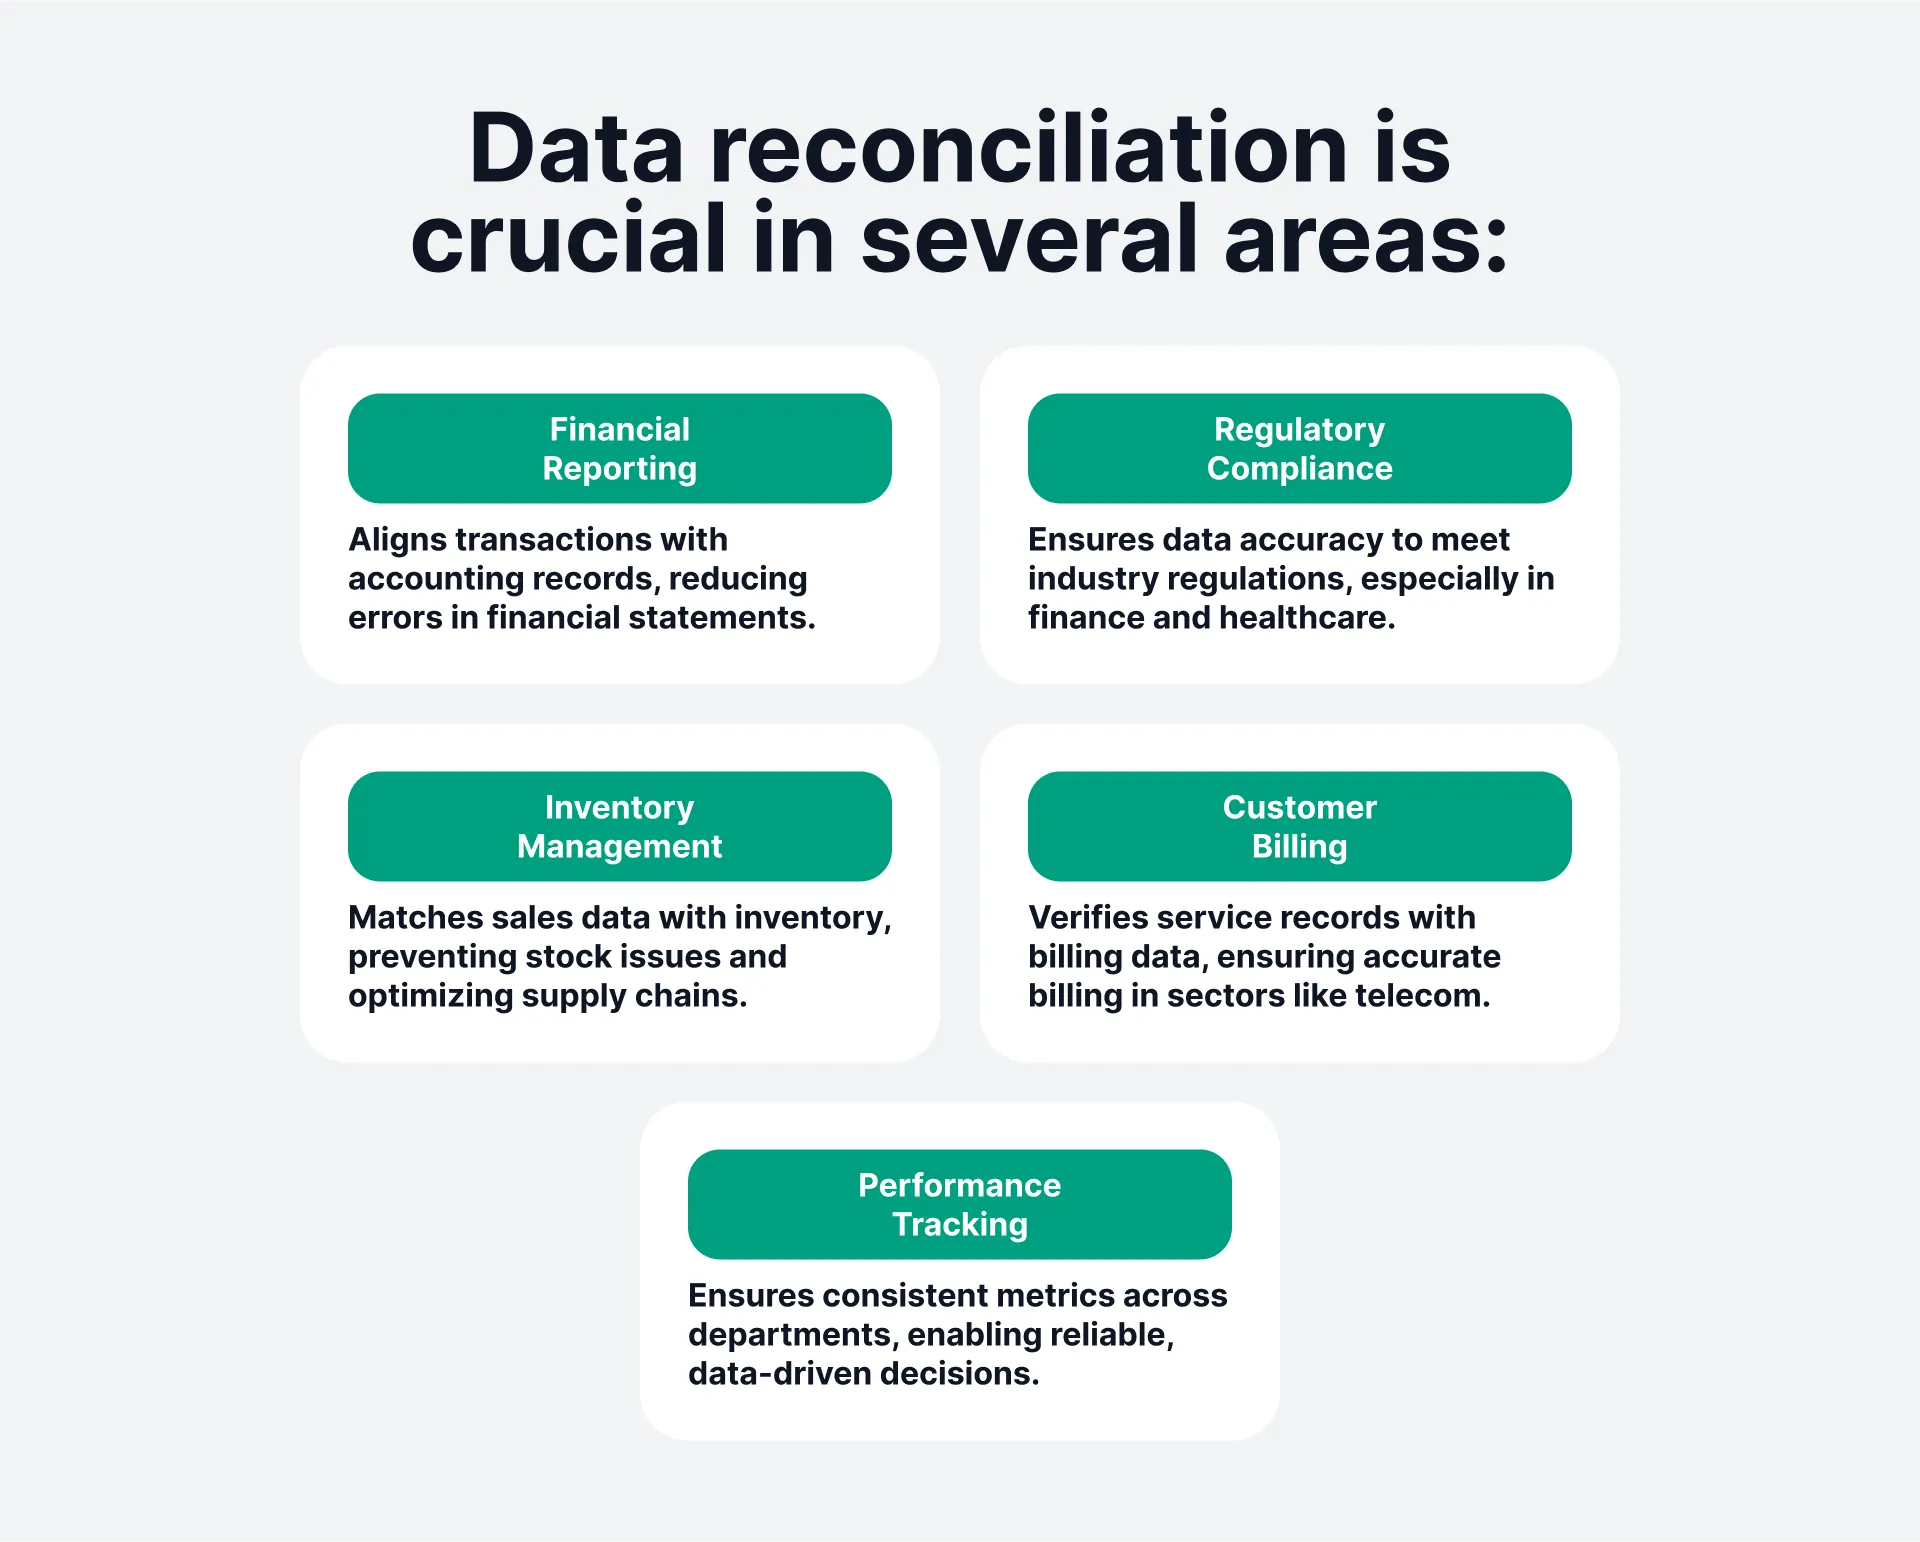
Ein Datenabgleich kann zum Beispiel so aussehen:
- Finanzdienstleistungen: Kontoauszüge mit der Buchhaltung abgleichen, um Fehler zu vermeiden und die regulatorische Compliance sicherzustellen.
- Gesundheitswesen: Patientenakten über verschiedene Systeme hinweg angleichen, um eine durchgehende Versorgung zu gewährleisten.
- Telekommunikation: Verbindungsdaten mit den Abrechnungssystemen abgleichen, um eine korrekte Abrechnung für die Kunden sicherzustellen.
- Fertigung: Sicherstellen, dass die Produktionsdaten mit den Bestandsdaten übereinstimmen, um den Verbrauch von Ressourcen zu überwachen und die Kosten effizient zu steuern.
Die drei Dinge, die damit gemeint sind
Bevor es weitergeht, lohnt es sich, drei Aufgaben zu trennen, die sich den Namen teilen, denn ein guter Teil der Verwirrung in Projekten zum Abgleich entsteht, wenn zwei Menschen das Wort für verschiedene Arbeit verwenden und es nicht bemerken.
| Art | Was verglichen wird | Was „abgeglichen“ bedeutet |
|---|---|---|
| Finanzieller Abgleich | Salden und Transaktionen zwischen einem Hauptbuch und einem Kontoauszug, einem Nebensystem oder den Büchern einer anderen Einheit | Jede Differenz ist entweder beseitigt oder erklärt und dokumentiert |
| Abgleich von Pipelines | Ein Datensatz an seiner Quelle gegenüber demselben Datensatz, nachdem er verschoben, transformiert oder migriert wurde | Zeilenzahlen, Summen und Schlüsselmengen stimmen zwischen Quelle und Ziel innerhalb einer vereinbarten Toleranz überein |
| Abgleich von Stammdaten | Datensätze, die denselben realen Kunden, dasselbe Produkt oder denselben Lieferanten in mehreren Systemen beschreiben | Ein vereinbarter Datensatz je realer Entität, mit den verknüpften Dubletten |
Sie liegen auch bei unterschiedlichen Menschen und laufen in unterschiedlichen Takten. Der finanzielle Abgleich gehört Finanzen und Buchhaltung im täglichen oder monatlichen Zyklus, der Abgleich von Pipelines dem Data Engineering je Ladevorgang oder je Umstellung einer Migration, und der Abgleich von Stammdaten den Data Stewards, fortlaufend statt in einem Zyklus.
Die Unterscheidung ist wichtig, weil die drei aus unterschiedlichen Gründen scheitern und von unterschiedlichen Menschen behoben werden. Ein Finanzteam, das um Hilfe beim Abgleich bittet, will den Monat abschließen. Ein Engineering-Team, das dieselbe Frage stellt, will beweisen, dass eine Migration keine Zeilen verloren hat. Die eine Frage mit der Antwort auf die andere zu beantworten, ist der Weg, auf dem Projekte zum Abgleich stocken.
Gemeinsam ist ihnen der Teil, der niemandem gehört: sich darauf zu einigen, was überhaupt hätte übereinstimmen sollen. Das ist eine Frage der Definition, keine technische, und genau darum geht es im Rest dieses Artikels.
Wie der Datenabgleich funktioniert, Schritt für Schritt
Welche Art Sie auch durchführen, die Form besteht aus denselben fünf Schritten.
1. Festlegen, was übereinstimmen soll, und mit welcher Toleranz. Das ist der Schritt, der übersprungen wird, und der Schritt, der entscheidet, ob der Rest funktioniert. Gleichen Sie die Zahl der Transaktionen ab, den Wert oder beides? Ist ein Unterschied von einem Cent eine Abweichung oder ein Rundungsfehler? Sollen beide Seiten dieselbe Menge an Datensätzen enthalten, und wenn nicht, welche Ausschlüsse sind zulässig? Schreiben Sie das auf, bevor Sie irgendetwas ausführen, denn wer es erst danach entscheidet, entscheidet es so, dass die aktuellen Zahlen akzeptabel aussehen.
2. Beide Seiten zu einem vergleichbaren Zeitpunkt auslesen. Zwei Systeme, die zu unterschiedlichen Zeitpunkten gelesen werden, sind sich über alles uneinig, was sich dazwischen bewegt hat, und dieser Unterschied ist kein Problem der Datenqualität. Legen Sie zuerst den Stichtag fest, sonst verbringen Sie die Übung damit, Ihr eigenes Timing zu untersuchen.
3. Über einen vereinbarten Schlüssel zuordnen. Wo es eine gemeinsame Kennung gibt, ist das einfach. Wo nicht, fällt die Zuordnung auf Kombinationen von Attributen zurück, und an diesem Punkt wird der Abgleich unbemerkt zu einer Übung in Modellierung, mit allen Ermessensfragen, die das mit sich bringt.
4. Einordnen, was nicht übereinstimmte. Nicht alle Abweichungen sind gleich, und sie als einen Haufen zu behandeln, ist der Grund, warum sich der Abgleich endlos anfühlt. Zeitliche Abweichungen lösen sich im nächsten Zyklus von selbst. Strukturelle Abweichungen bedeuten, dass eine Transformation Datensätze verliert oder verdoppelt. Definitorische Abweichungen bedeuten, dass die beiden Systeme nie dasselbe gezählt haben. Nur die erste Art ist harmlos.
5. Auflösen und die Ursache festhalten. Die Auflösung ist die sichtbare Arbeit. Festzuhalten, warum es passiert ist, ist die Arbeit, die sich auszahlt, denn einer Abweichung mit dokumentierter Ursache lässt sich vorbeugen, und eine Abweichung, die immer nur korrigiert wird, kommt im nächsten Monat genau gleich wieder.
Diese vierte Kategorie lohnt einen genaueren Blick. Eine definitorische Abweichung ist überhaupt kein Datenproblem. Sie entsteht, wenn zwei Teams sich auf unterschiedliche Bedeutungen geeinigt haben und es erst weiter unten merken, und keine Zuordnungslogik löst sie, weil beide Systeme richtig liegen, nur bei unterschiedlichen Fragen. Das ist die Brücke zu allem, was folgt.
Die Rolle der Data Governance beim Abgleich
Data Governance liefert den Rahmen, der nötig ist, um den Datenabgleich zu vereinheitlichen und zu vereinfachen, und sie schafft Einheitlichkeit durch festgelegte Regeln, Strukturen und Verantwortlichkeiten. Dieser Rahmen unterstützt den Datenabgleich, indem er Mehrdeutigkeit verringert und die Richtigkeit verbessert. Wird Data Governance wirksam angewendet, setzt sie Standards für Datenqualität, Prüfung und Nutzung durch, sodass sich Abweichungen leichter auflösen und Daten über Systeme hinweg angleichen lassen.
Ein entscheidender Teil dieses Rahmens ist ein gemeinsames Datenwörterbuch oder ein Katalog, der als gemeinsame Sprache über Abteilungen hinweg dient. Dieses Werkzeug erlaubt es Fachleuten aus verschiedenen Bereichen, ob Finanzen, Vertrieb oder Risikomanagement, nicht nur mit Daten zu arbeiten, sondern gemeinsam zu definieren, was sie genau bedeuten, und sicherzustellen, dass alle sie einheitlich deuten. Wenn sich Teams auf klare Definitionen und Begriffe einigen, schaffen sie ein gemeinsames Verständnis wichtiger Datenattribute, Kennzahlen und Prozesse. Dieses gemeinsame Verständnis ist unverzichtbar für eine offene Kommunikation und macht den Abgleich weit reibungsloser und weniger fehleranfällig, weil sich jede Abteilung auf dieselbe „Übersetzung“ der Begriffe verlassen kann.
In der regulierten Berichterstattung ist das keine Frage der Bequemlichkeit mehr. Die Grundsätze für die effektive Aggregation von Risikodaten und die Risikoberichterstattung des Basler Ausschusses beruhen auf der Erwartung, dass ein Institut seine Risikodaten zusammenführen und zeigen kann, dass die gemeldeten Zahlen standhalten. Ein Institut, das nicht nachweisen kann, dass seine Systeme übereinstimmen, kann nicht nachweisen, dass sein Bericht richtig ist, und der Abgleich ist der Weg, auf dem diese Übereinstimmung belegt wird.
Ein Data Catalog als Übersetzer: eine gemeinsame Sprache für Daten schaffen
Ein Datenkatalog ist mehr als ein Speicher für Metadaten; er ist ein Werkzeug der Kommunikation, das Unternehmen hilft, ihr Verständnis und ihre Nutzung von Daten über Abteilungen hinweg anzugleichen. Stellen Sie sich vor, in einem Unternehmen spricht die Finanzabteilung „Spanisch“ und der Vertrieb „Französisch“. Ohne ein gemeinsames Glossar können Missverständnisse entstehen, obwohl scheinbar alle über dasselbe Thema sprechen. Der Datenkatalog wirkt wie ein „Übersetzungswörterbuch“ und macht es möglich, Begriffe wie „Umsatz“ oder „Gewinn“ mit genauen, einheitlichen Definitionen zu dokumentieren, die alle verstehen.
In einem Telekommunikationsunternehmen kann der Begriff „Kunde“ zum Beispiel für verschiedene Abteilungen Verschiedenes bedeuten. Für die Rechtsabteilung ist ein Kunde jeder mit einem Vertrag; für die Finanzabteilung jemand, der mindestens 1 Kč ausgegeben hat; und für das technische Team jede Person, die mindestens 1 KB an Daten übertragen hat.
Dieses Beispiel lohnt es, zweimal zu lesen, denn es ist eine definitorische Abweichung, die nur darauf wartet, einzutreten. Drei Systeme melden drei verschiedene Kundenzahlen, alle richtig, und jeden Monat gleicht jemand sie ab und findet eine Differenz, die keine Zuordnungsregel schließen kann. Im Business Glossary wird das einmal geklärt, statt immer wieder untersucht zu werden.
Ein Datenkatalog, der von Data Stewards gepflegt und definiert wird, erlaubt es Finanzen und Vertrieb, ihre Auslegungen anzugleichen, sodass sie mit denselben Definitionen arbeiten und Missverständnisse abnehmen. Diese Angleichung bildet die Grundlage dafür, im ganzen Unternehmen „eine Sprache zu sprechen“.
Ein Szenario aus der Praxis: Einheitlichkeit der Daten durch Zusammenarbeit
Nehmen Sie ein Unternehmen, das Stahl verkauft. Jede Abteilung hat andere Anforderungen an Daten und andere Zuständigkeiten:
- Vertrieb: Erfasst die verkaufte Menge Stahl in Tonnen und konzentriert sich auf die Vertriebskennzahlen, die für seine KPIs zählen.
- Finanzen: Ergänzt Preise und Kosten und berechnet den Nettogewinn, indem die Kosten vom Umsatz abgezogen werden.
- Risikomanagement: Ergänzt einen Risikokoeffizienten und passt die Erwartungen an die Zahlungshistorie des Kunden an.
- Technik: Verwaltet produktspezifische Angaben wie Stahlsorten und Spezifikationen.
Jedes Team trägt seinen Teil zur Datenlandschaft bei, doch ohne einen zentralen Speicher wie einen Datenkatalog passen ihre Auslegungen und KPIs womöglich nicht zusammen. Über den Datenkatalog sieht jedes Team, wie seine Datenattribute definiert und mit übergeordneten Kennzahlen verbunden sind, sodass alle im Gleichklang arbeiten können. Die Finanzabteilung braucht zum Beispiel die Mengen vom Vertrieb und die Zahlungswahrscheinlichkeit vom Risikomanagement, um den tatsächlichen Gewinn zu schätzen. Das Vertriebsteam wiederum sieht, welche Definitionen die Finanzkennzahlen bestimmen, an denen es gemessen wird, was eine kooperative und offene Datenumgebung fördert.
Data Lineage übernimmt hier die andere Hälfte der Arbeit. Sobald eine Abweichung gefunden ist, macht die Lineage aus „diese beiden Zahlen stimmen nicht überein“ ein „an dieser Transformation sind sie auseinandergelaufen“, und das ist der Unterschied zwischen einer Untersuchung und einer Behebung.
Vorteile eines Data Catalog für den Datenabgleich
Mit einem Datenkatalog genießen Unternehmen mehrere wichtige Vorteile, die den Datenabgleich verbessern:
- Einheitliche Begriffe und Definitionen: Ein Katalog bietet einen einzigen, gepflegten Speicher für Begriffe und Definitionen, auf den alle Abteilungen zugreifen können. Diese Vereinheitlichung erlaubt es allen, mit denselben Definitionen zu arbeiten, und verringert Mehrdeutigkeit.
- Bessere Kommunikation: Indem der Katalog die Beziehungen zwischen Datenattributen und fachlichen Definitionen dokumentiert, wird er zur Brücke zwischen Abteilungen. Teams sehen, wie bestimmte Kennzahlen oder KPIs berechnet werden, was Diskussionen fundierter macht.
- Klarere Verantwortung: Data Governance weist bestimmten Datenelementen eine Zuständigkeit zu. Im Beispiel oben gehören der Finanzabteilung die Finanzberechnungen, dem Vertrieb die Mengenkennzahlen und dem Risikomanagement die Risikoanpassungen. Diese Verantwortung vereinfacht den Abgleich.
- Transparenz und Vertrauen in Daten: Indem ein Datenkatalog Definitionen und Data Lineage für alle zugänglich macht, fördert er das Vertrauen in Daten und hilft Teams, Entscheidungen sicher auf gemeinsame, richtige Daten zu stützen.
Fazit
Datenabgleich, gestützt auf eine belastbare Data Governance, ist unverzichtbar für Unternehmen, die richtige und einheitliche Daten über Systeme hinweg bewahren wollen. Der Datenkatalog spielt in diesem Prozess eine entscheidende Rolle als Werkzeug für Kommunikation und Angleichung, mit dem verschiedene Abteilungen auf einem gemeinsamen Verständnis ihrer Daten arbeiten können. Indem Unternehmen Datenattribute und Begriffe dokumentieren, definieren und teilen, schaffen sie eine Grundlage aus Transparenz und Vertrauen, verbessern letztlich die Datenqualität und unterstützen ihre strategischen Ziele.
Der praktische Test, ob es funktioniert, ist nicht, wie schnell Sie einen Abgleich abschließen. Er liegt darin, ob dieselbe Abweichung im nächsten Monat wiederkommt.
FAQ
Was ist Datenabgleich?
Was ist der Unterschied zwischen dem Abgleich und der Validierung von Daten?
Welche Hauptarten des Datenabgleichs gibt es?
Wie wird ein Datenabgleich durchgeführt?
Was verursacht Abweichungen beim Abgleich?
Warum ist der Datenabgleich für die Compliance wichtig?
Quellen
- Basel Committee on Banking Supervision - Principles for effective risk data aggregation and risk reporting, Januar 2013
In Aktion erleben
Dawiso Data Catalog
Eine vereinbarte Definition je Fachbegriff, damit dieselbe Abweichung nicht mehr jeden Monat wiederkommt.