Warum belastbare Data Governance für unstrukturierte Daten unerlässlich ist
Unstrukturierte Daten im großen Maßstab zu steuern ist eine der größten Herausforderungen in vielen Unternehmen. Die öffentliche Auseinandersetzung mit diesem wichtigen Thema ist begrenzt, was viele Unternehmen mit der Komplexität unstrukturierter Daten allein lässt. Heute, da eine neue Zeit der generativen KI beginnt, war es nie dringender, diese Herausforderungen anzugehen.
Einst als undurchsichtiges Nebenprodukt des Geschäfts geduldet, stehen unstrukturierte Daten heute im Zentrum dessen, wie wir uns verständigen, entscheiden und KI-Modelle trainieren. Interne Verfahren, SOPs, Berichte, Präsentationen, Aufzeichnungen, Chatverläufe, Bildschirmfotos und eingescannte Dokumente machen einen gewaltigen Teil der Unternehmensdaten aus. Das meiste davon bleibt jedoch ungesteuert, ungeregelt und für die Datensysteme des Unternehmens unsichtbar.
Das ist ein Risiko und eine verpasste Gelegenheit zugleich. Unstrukturierte Daten zu regeln ist das Fundament dafür, sie sicher, wirksam und in einer Weise zu nutzen, die im Unternehmen wie in Ihren KI-Vorhaben mitwächst.
Warum sind unstrukturierte Daten schwer zu regeln?
Unstrukturierte Daten haben kein vorgegebenes Schema. Ihre Bedeutung hängt am Zusammenhang und verteilt sich über Absätze oder Seiten.
Häufige Schwierigkeiten sind schlechte Sichtbarkeit: Dokumente liegen in unverbundenen Systemen, auf Laufwerken, in SharePoint, in Postfächern, ohne Nachvollziehbarkeit. Metadaten sind nicht vereinheitlicht, sodass den Dateien oft Beschreibungen, Kennzeichnungen, Verantwortung oder Verknüpfungen zu fachlichen Definitionen fehlen. Sensible Angaben (etwa personenbezogene Daten oder abgelaufene Verträge) bleiben womöglich unbemerkt und ungeschützt.
Und doch werden diese Daten in Abläufe des Unternehmens gezogen, besonders in KI-Vorhaben, ohne genügend Kontext, ohne Prüfung der Qualität und ohne Erklärbarkeit. Das ist ein Problem der Governance.
Wie regelt man unstrukturierte Daten?
Wie erwähnt können Sie sich bei unstrukturierten Inhalten anders als bei strukturierten Daten nicht auf vorgefertigte Schemata oder Datenmodelle stützen. Governance muss sich stattdessen auf Metadaten, Verantwortung und Kontext richten.
Ein belastbarer Ansatz für die Data Governance unstrukturierter Daten sollte umfassen:
1. Metadaten anreichern
Kategorien, Kennzeichnungen und Beschreibungen automatisch oder von Hand vergeben.
2. Verantwortung und Rechenschaft
Festlegen, wer die Inhalte betreut und wer darauf zugreifen oder sie ändern darf.
3. Lineage und Versionierung
Nachhalten, wann Dokumente entstanden oder geändert wurden und warum.
4. Verknüpfung mit strukturierten Begriffen
Unstrukturierte Inhalte mit KPIs, Begriffen aus dem Business Glossary oder Datendomänen verbinden.
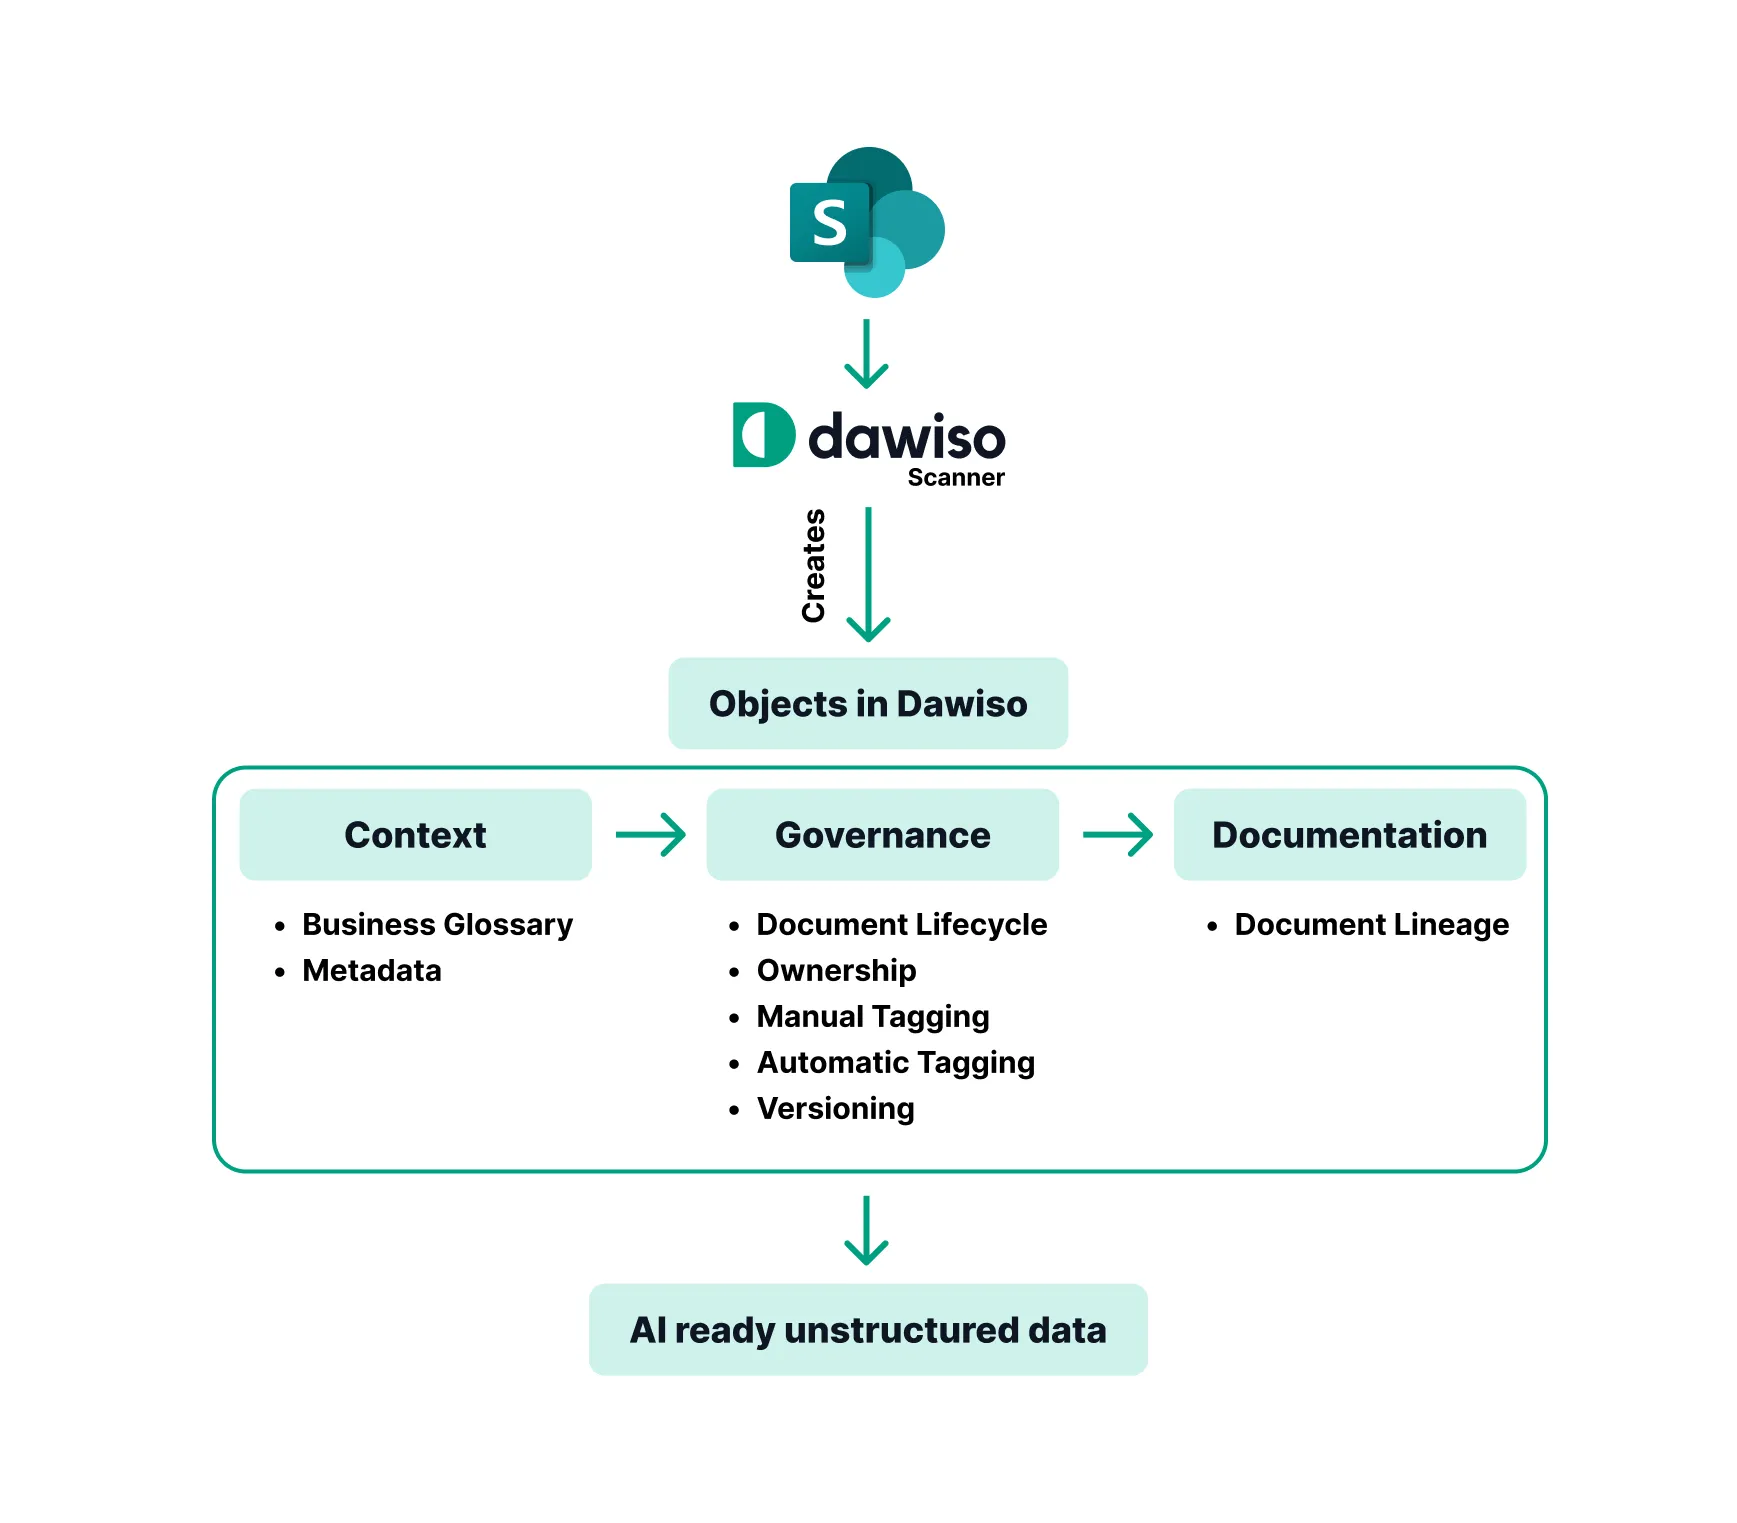
Ein Schichtenmodell für die Data Governance unstrukturierter Daten
Nehmen wir uns ein Beispiel an Rahmenwerken wie der Medallion-Architektur, die ursprünglich für Pipelines mit strukturierten Daten entworfen wurde, und wenden ein ähnliches Schichtenmodell der Governance auf unstrukturierte Inhalte an. So lassen sich Daten nach Nutzbarkeit und Güte ordnen.
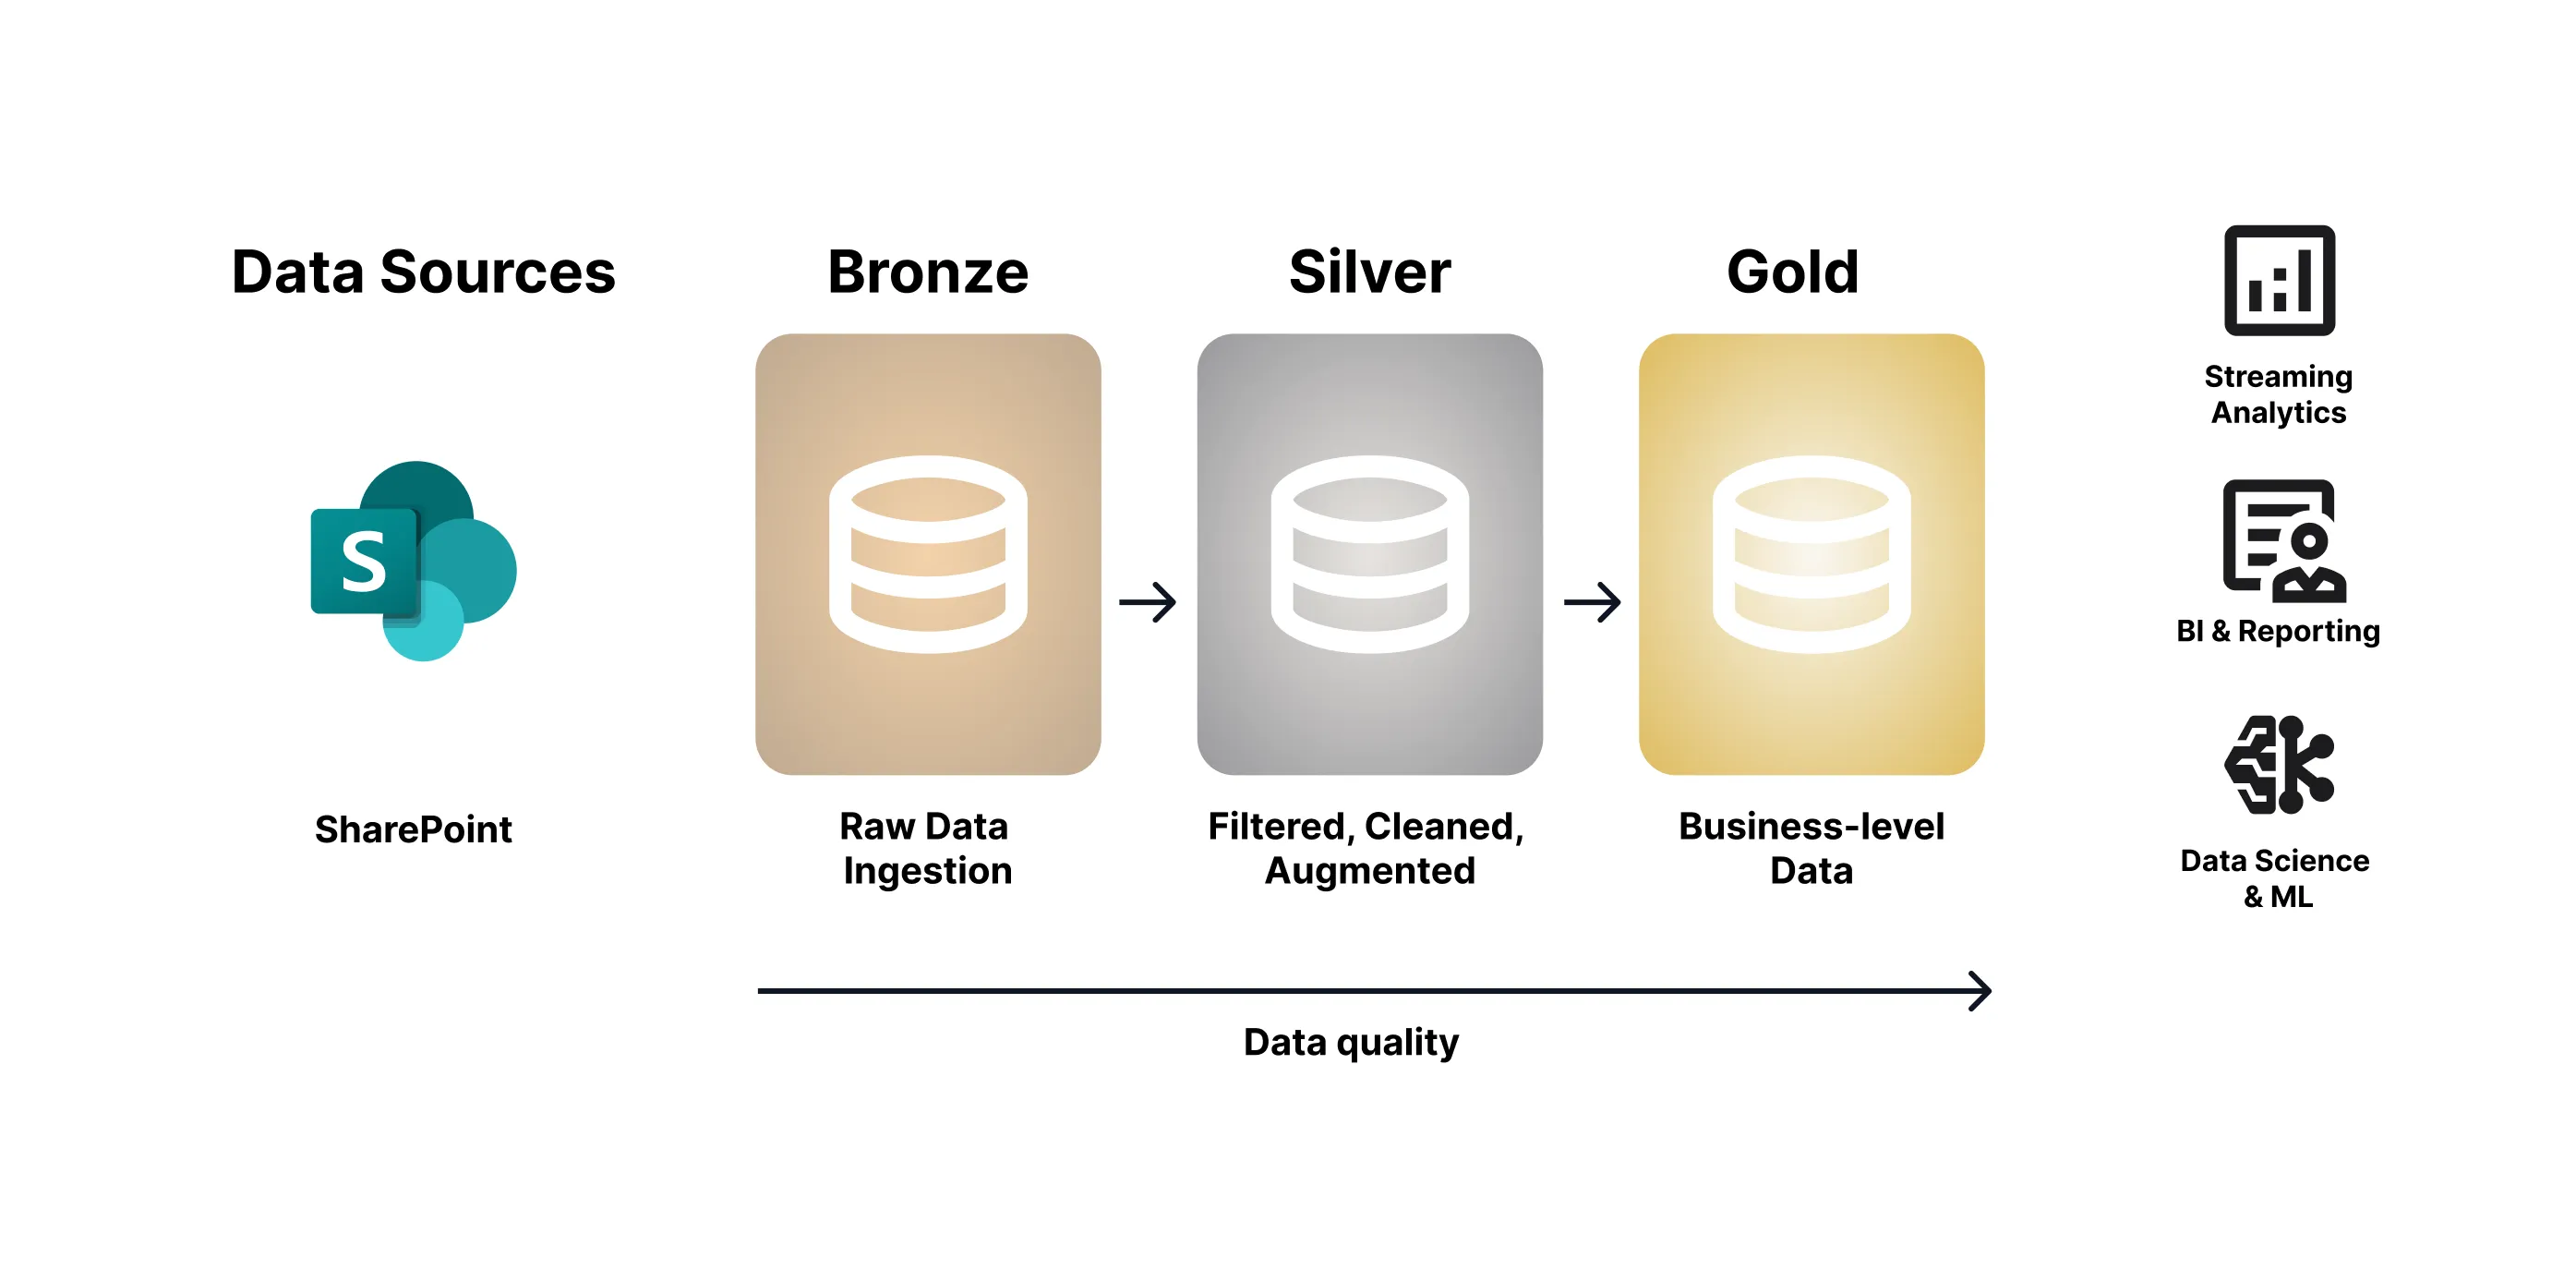
1. Bronze Layer: rohe Ablage
- Dokumente und Dateien in ihrem ursprünglichen Zustand übernehmen.
- Grundlegende Metadaten erfassen, etwa Quellsystem, Erstellungsdatum und zuständiges Team.
- Mit möglichst wenig Verarbeitung, aber klarer Verantwortung ablegen.
2. Silver Layer: strukturieren und verknüpfen
- Inhalte mit erkannten Entitäten, Kategorien und Verknüpfungen ins Glossar anreichern.
- Die automatische Verknüpfung und die Zusammenfassung per KI in Dawiso nutzen, um sinnvolle Verbindungen zu schaffen.
- Namenskonventionen vereinheitlichen und die Güte der Metadaten prüfen.
3. Gold Layer: gepflegt, durchsuchbar, KI-ready
- Inhalte über Portale der Governance in allen Geschäftseinheiten auffindbar machen.
- Retrieval-Augmented Generation (RAG) durch LLMs auf gepflegten, vertrauenswürdigen Dokumenten unterstützen.
- Unstrukturierte Daten in Dashboards, Abläufe und Berichte zur Compliance einbetten.
Retrieval-Augmented Generation
Einer der wirksamsten Wege, heute Nutzen aus unstrukturierten Inhalten zu ziehen, ist Retrieval-Augmented Generation (RAG), ein Rahmen, der die Ausgaben großer Sprachmodelle (LLM) verbessert, indem er aktuelles externes Wissen in den Antwortvorgang einspeist.
Praktisch heißt das: KI ist nicht länger auf starres, vortrainiertes Wissen beschränkt. Mit RAG kann sie im Moment einer Frage einschlägige, aktuelle Inhalte holen, etwa interne Dokumentation, Berichte, Richtlinien oder Artikel aus der Wissensdatenbank. Das Modell nutzt diesen geholten Kontext für Antworten, die nicht nur einschlägiger sind, sondern sich auch auf bestimmte Datenquellen zurückführen lassen.
Dafür beginnt der Vorgang damit, unstrukturierte Dokumente zu sammeln, die für einen bestimmten Anwendungsfall einschlägig sind. Diese Dokumente werden dann in kleinere, handliche Stücke zerlegt. Jedes Stück wird in ein Vektor-Embedding umgewandelt, also in eine zahlenmäßige Form, die die Bedeutung des Textes einfängt. All diese Embeddings liegen in einer Vektordatenbank, in der ähnliche Inhalte nach ihrer Bedeutung nahe beieinander liegen.
Stellt jemand eine Frage, durchsucht das System diese Vektordatenbank nach den einschlägigsten Stücken. Sie gehen dann zusammen mit der Frage an das Sprachmodell, erweitern dessen Verständnis und erlauben ihm, genauere Antworten mit Kontext zu geben.
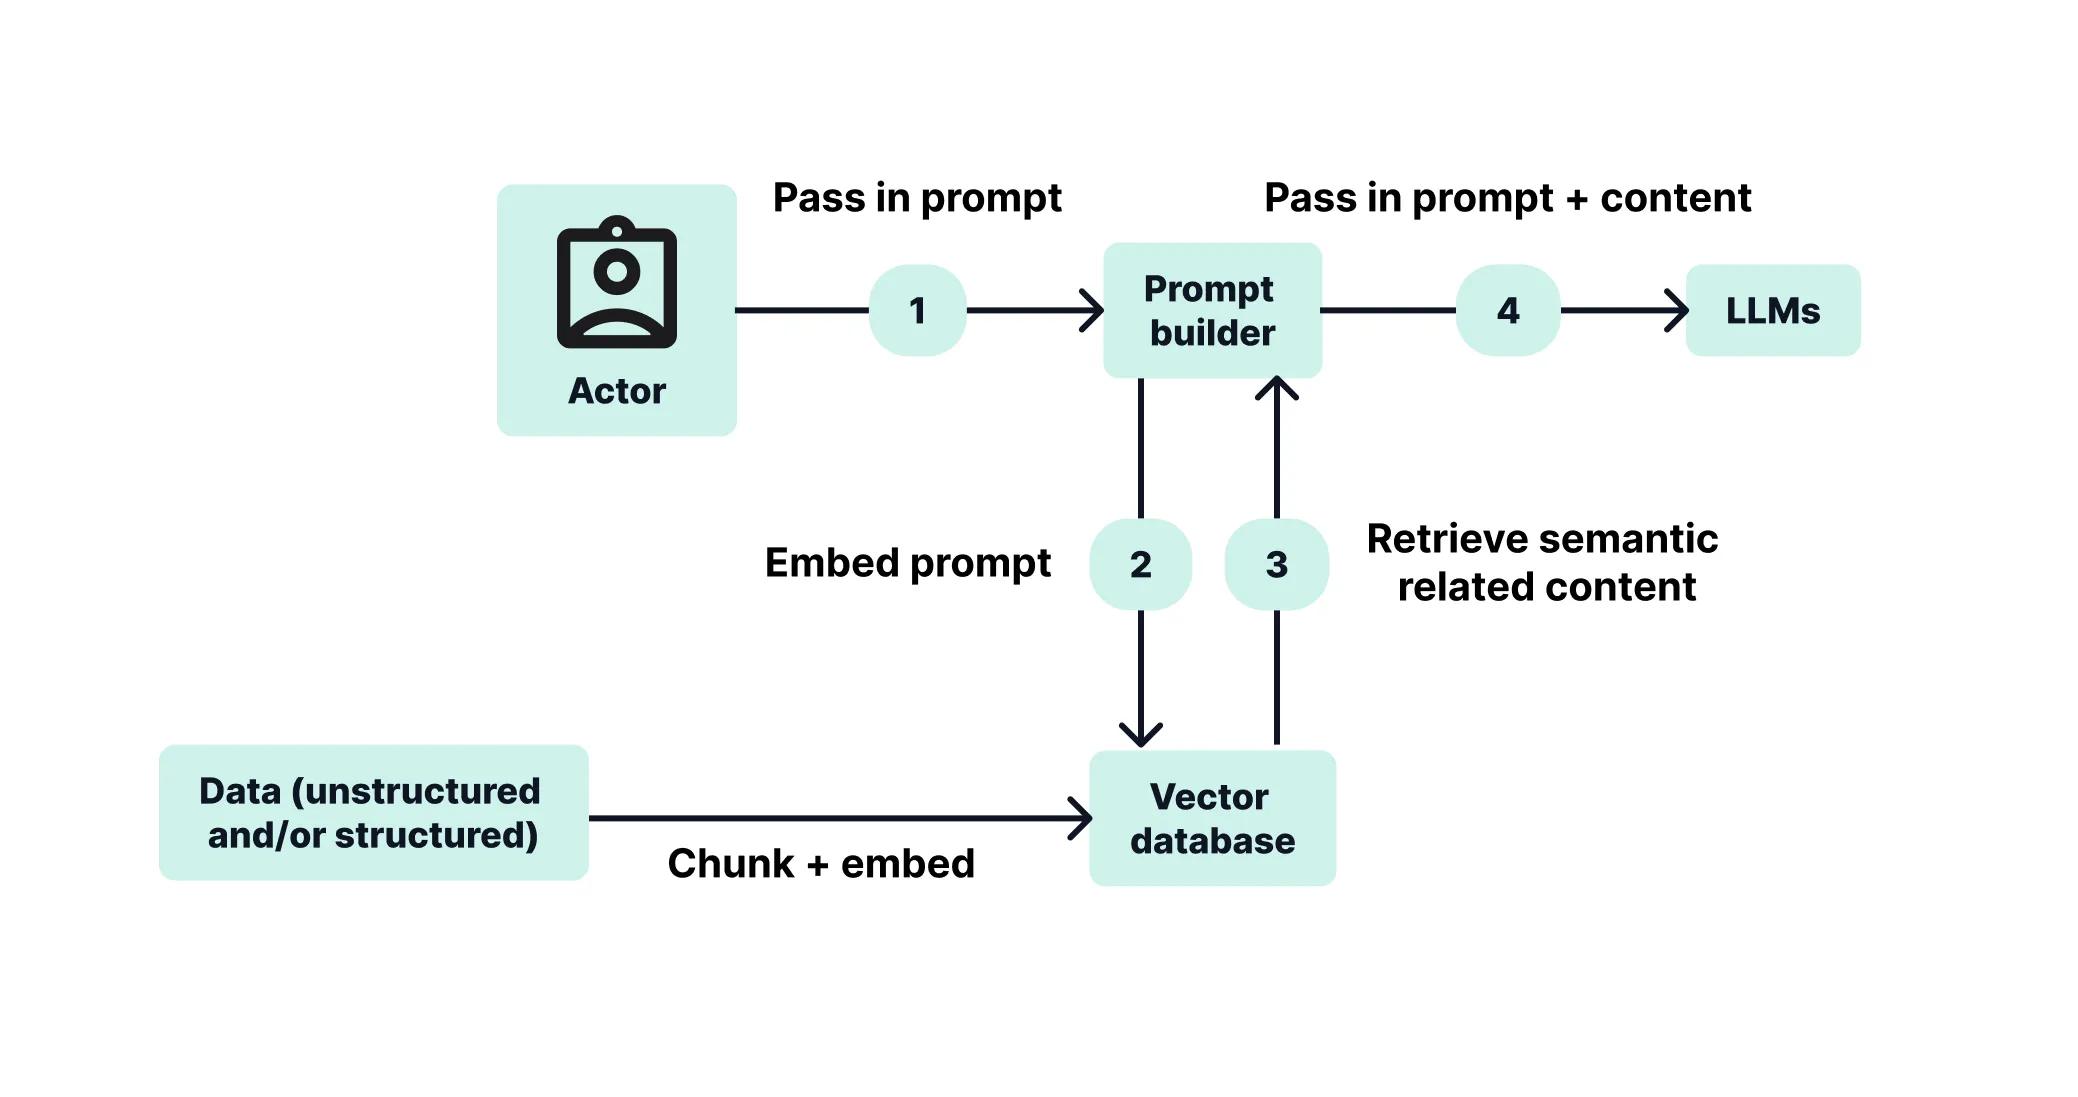
Dieser ganze Ablauf hängt daran, dass die Quellinhalte gut geregelt und verlässlich sind. Ist Ihre Dokumentation veraltet, widersprüchlich oder schlecht beschriftet, riskieren Sie fehlerhafte oder irreführende Ausgaben. Und wenn diese Inhalte sensible Daten enthalten, etwa Finanzrichtlinien, Verträge oder Vorgaben zur Compliance, wiegen Ungenauigkeiten noch schwerer.
Jetzt sehen Sie genau, wo Dawiso eine entscheidende Rolle spielt. Indem es Governance in den Lebenszyklus unstrukturierter Inhalte einbaut, Verantwortung zuweist, Begrifflichkeit vereinheitlicht und für Widerspruchsfreiheit sorgt, stellt Dawiso sicher, dass die Dokumente, die Ihre KI-Systeme speisen, nicht nur auffindbar, sondern auch vertrauenswürdig sind. Es macht aus unstrukturierten Daten einen prüfbaren Bestand mit Kontext, der KI auf Basis von Retrieval sicher und transparent unterstützt.
Governance als Fundament vertrauenswürdiger unstrukturierter Daten
Unstrukturierte Inhalte als vollwertigen Datenbestand zu behandeln heißt, dieselbe Disziplin der Governance anzuwenden, die Sie von jedem geschäftskritischen Datensatz erwarten würden.
Im Bronze Layer beginnt Governance früh, bei der Übernahme. Sobald Dokumente über Plattformen zur Dokumentenverwaltung in Ihr System kommen, müssen Bezeichnungen, Metadaten und Verantwortung sofort vergeben werden. Hier hilft Dawiso, Klassifizierung und Zuweisung der Verantwortung zu automatisieren, sodass selbst rohe, unberührte Dateien nie ungesteuert bleiben. Gibt es Schwierigkeiten bei der Übernahme oder uneinheitliche Formate, sind kurze Rückkopplungen mit den liefernden Teams (etwa der Quellanwendung oder der Compliance) entscheidend, um die Integrität zu wahren.
Auch Sicherheit und Sensibilität beginnen hier. Vorgegebene Kennzeichnungen der Sensibilität und Klassifizierungsschemata sorgen dafür, dass personenbezogene Daten oder vertrauliche Geschäftsdokumente in Ihrer gesamten Architektur einheitlich geschützt sind. Verschlüsselung ist in dieser Phase wahlfrei, Kennzeichnung nicht. Ohne klaren Ausgangspunkt lässt sich eine sichere Wiederverwendung durch KI später nicht ausweiten.
Geht es weiter in den Silver Layer, verschiebt sich der Schwerpunkt auf Nutzbarkeit und Widerspruchsfreiheit. Hier werden die Stärken von Dawiso beim Anreichern von Metadaten, beim Einbinden des Glossars und beim automatischen Verknüpfen entscheidend. Dokumente lassen sich über festgelegte Formate, Namenskonventionen und domänenspezifische Kennzeichnungen vereinheitlichen und mit strukturierten Begriffen wie Leistungskennzahlen (KPIs) oder Geschäftsprozessen verbinden. Diese Verbindungen ordnen die Inhalte und schaffen kluge Verknüpfungen zwischen zusammengehörigen Informationen. So behalten Teams die Kontrolle über ihre Domäne, ohne Silos zu bauen.
Im Silver Layer wird die Arbeit an der Compliance feiner. Regelmäßige Durchsichten der Metadaten, Prüfungen und die Kontrolle der Dokumentgüte sichern die Integrität Ihrer unstrukturierten Bestände. Trägt ein Dokument eine Kennzahl in einem Dashboard oder wird es in einer Richtlinie zitiert, muss es aktuell und nachvollziehbar sein. In dieser Phase erlaubt Dawiso, Abläufe zur Veröffentlichung oder förmliche Freigaben zu starten und geregelte Bestände für den breiteren Einsatz vorzubereiten.
Im Gold Layer sorgt Governance dafür, dass Inhalte abrufbar, erklärbar und bereit für KI-Anwendungen sind. Hier sind die Inhalte gepflegt, durchsuchbar und auf Werkzeuge wie Retrieval-Augmented Generation (RAG) hin optimiert. Dokumente können nach Bedeutung zerlegt, in einem Vektorspeicher abgelegt und mit semantischen Metadaten verknüpft werden, die Abfragen in natürlicher Sprache erlauben. Ohne klar bestimmte Beziehungen zwischen Inhalt und Zusammenhang, also Verantwortung, fachliche Bedeutung und Nutzungsregeln, können diese weiter gehenden Fähigkeiten jedoch ins Leere laufen.
Dawiso wirkt hier als Bindeglied. Sein Katalog hält die Beziehungen zwischen Dokumenten, fachlichen Begriffen, Datenprodukten und Nutzern zusammen und stellt sicher, dass das, was eine KI abruft, nicht nur einschlägig, sondern auch sicher, aktuell und verständlich ist.
Die neuen Rollen hinter der Data Governance unstrukturierter Daten
Während Unternehmen ihre Governance über strukturierte und unstrukturierte Inhalte hinweg ausweiten, entstehen neue Rollen, die dieser Komplexität gerecht werden.
- Data Owners bleiben für Güte und Rechenschaft zuständig, auch für unstrukturierte Inhalte, die wichtige Geschäftsprozesse tragen.
- Context Engineers übernehmen die entscheidende Aufgabe, Bedeutung hinzuzufügen, also Dokumente mit einschlägigen Metadaten, Begriffen aus dem Glossar und fachlichem Zusammenhang anzureichern, damit sie sich wiederverwenden und richtig deuten lassen.
- Value Engineers schlagen die Brücke zwischen Governance und dem Nutzen der KI, indem sie sich darauf richten, wie geregelte unstrukturierte Daten in kluge Systeme und Auswertungen einfließen und fachliche Wirkung entfalten. Mit dem Aufkommen kontextbewusster Protokolle wie dem Model Context Protocol (MCP) wächst der Bedarf an Fachleuten, die Geschäftsprozesse und deren Zusammenhang verstehen. Diese Fachleute schärfen Inhalte, ergänzen Kontext und bilden komplexe Geschäftsszenarien ab, damit Agenten wirksam arbeiten können.
- Prompt Engineers sind in Umgebungen mit eingebauter KI heute unverzichtbar. Während kontextbewusste Protokolle wie das Model Context Protocol (MCP) reifen, gestalten, schärfen und pflegen sie das Zusammenspiel zwischen Daten, Menschen und LLM-Agenten. Sie übersetzen fachlichen Bedarf in genaue Eingaben, wählen die einschlägigen Quellen und steuern, wie Informationen zwischen den Wissensschichten und den generativen Werkzeugen fließen.
Zusammen stehen diese Rollen für eine breitere kulturelle Verschiebung: Kontext und Vertrauen werden als gemeinsame Verantwortung begriffen, nicht als Nachgedanke.