Worin unterscheiden sich OpenMetadata und der Data Catalog von Dawiso?
OpenMetadata ist zum Standard für quelloffene Data Governance geworden. Mit vergleichsweise einfachem Betrieb und geringen Kosten ist es oft das Mittel der Wahl für kleinere Teams, die ein bezahlbares Metadatenmanagement suchen. Aber ist es das richtige?
Dieser Beitrag vergleicht zwei grundlegend verschiedene Ansätze: OpenMetadata, ein quelloffenes, von einer Gemeinschaft getragenes Rahmenwerk, und Dawiso, einen von einem Anbieter betreuten Datenkatalog, der von Haus aus eingängig, zugänglich und bereit für Governance sein soll. Wir sehen uns ihre Stärken und Grenzen an und wie Sie die passende Wahl für Ihr Unternehmen treffen, ob Ihnen Flexibilität und Kontrolle wichtiger sind oder Einfachheit und langfristiger Support.
OpenMetadata und Dawiso: ein Vergleich aus der Praxis
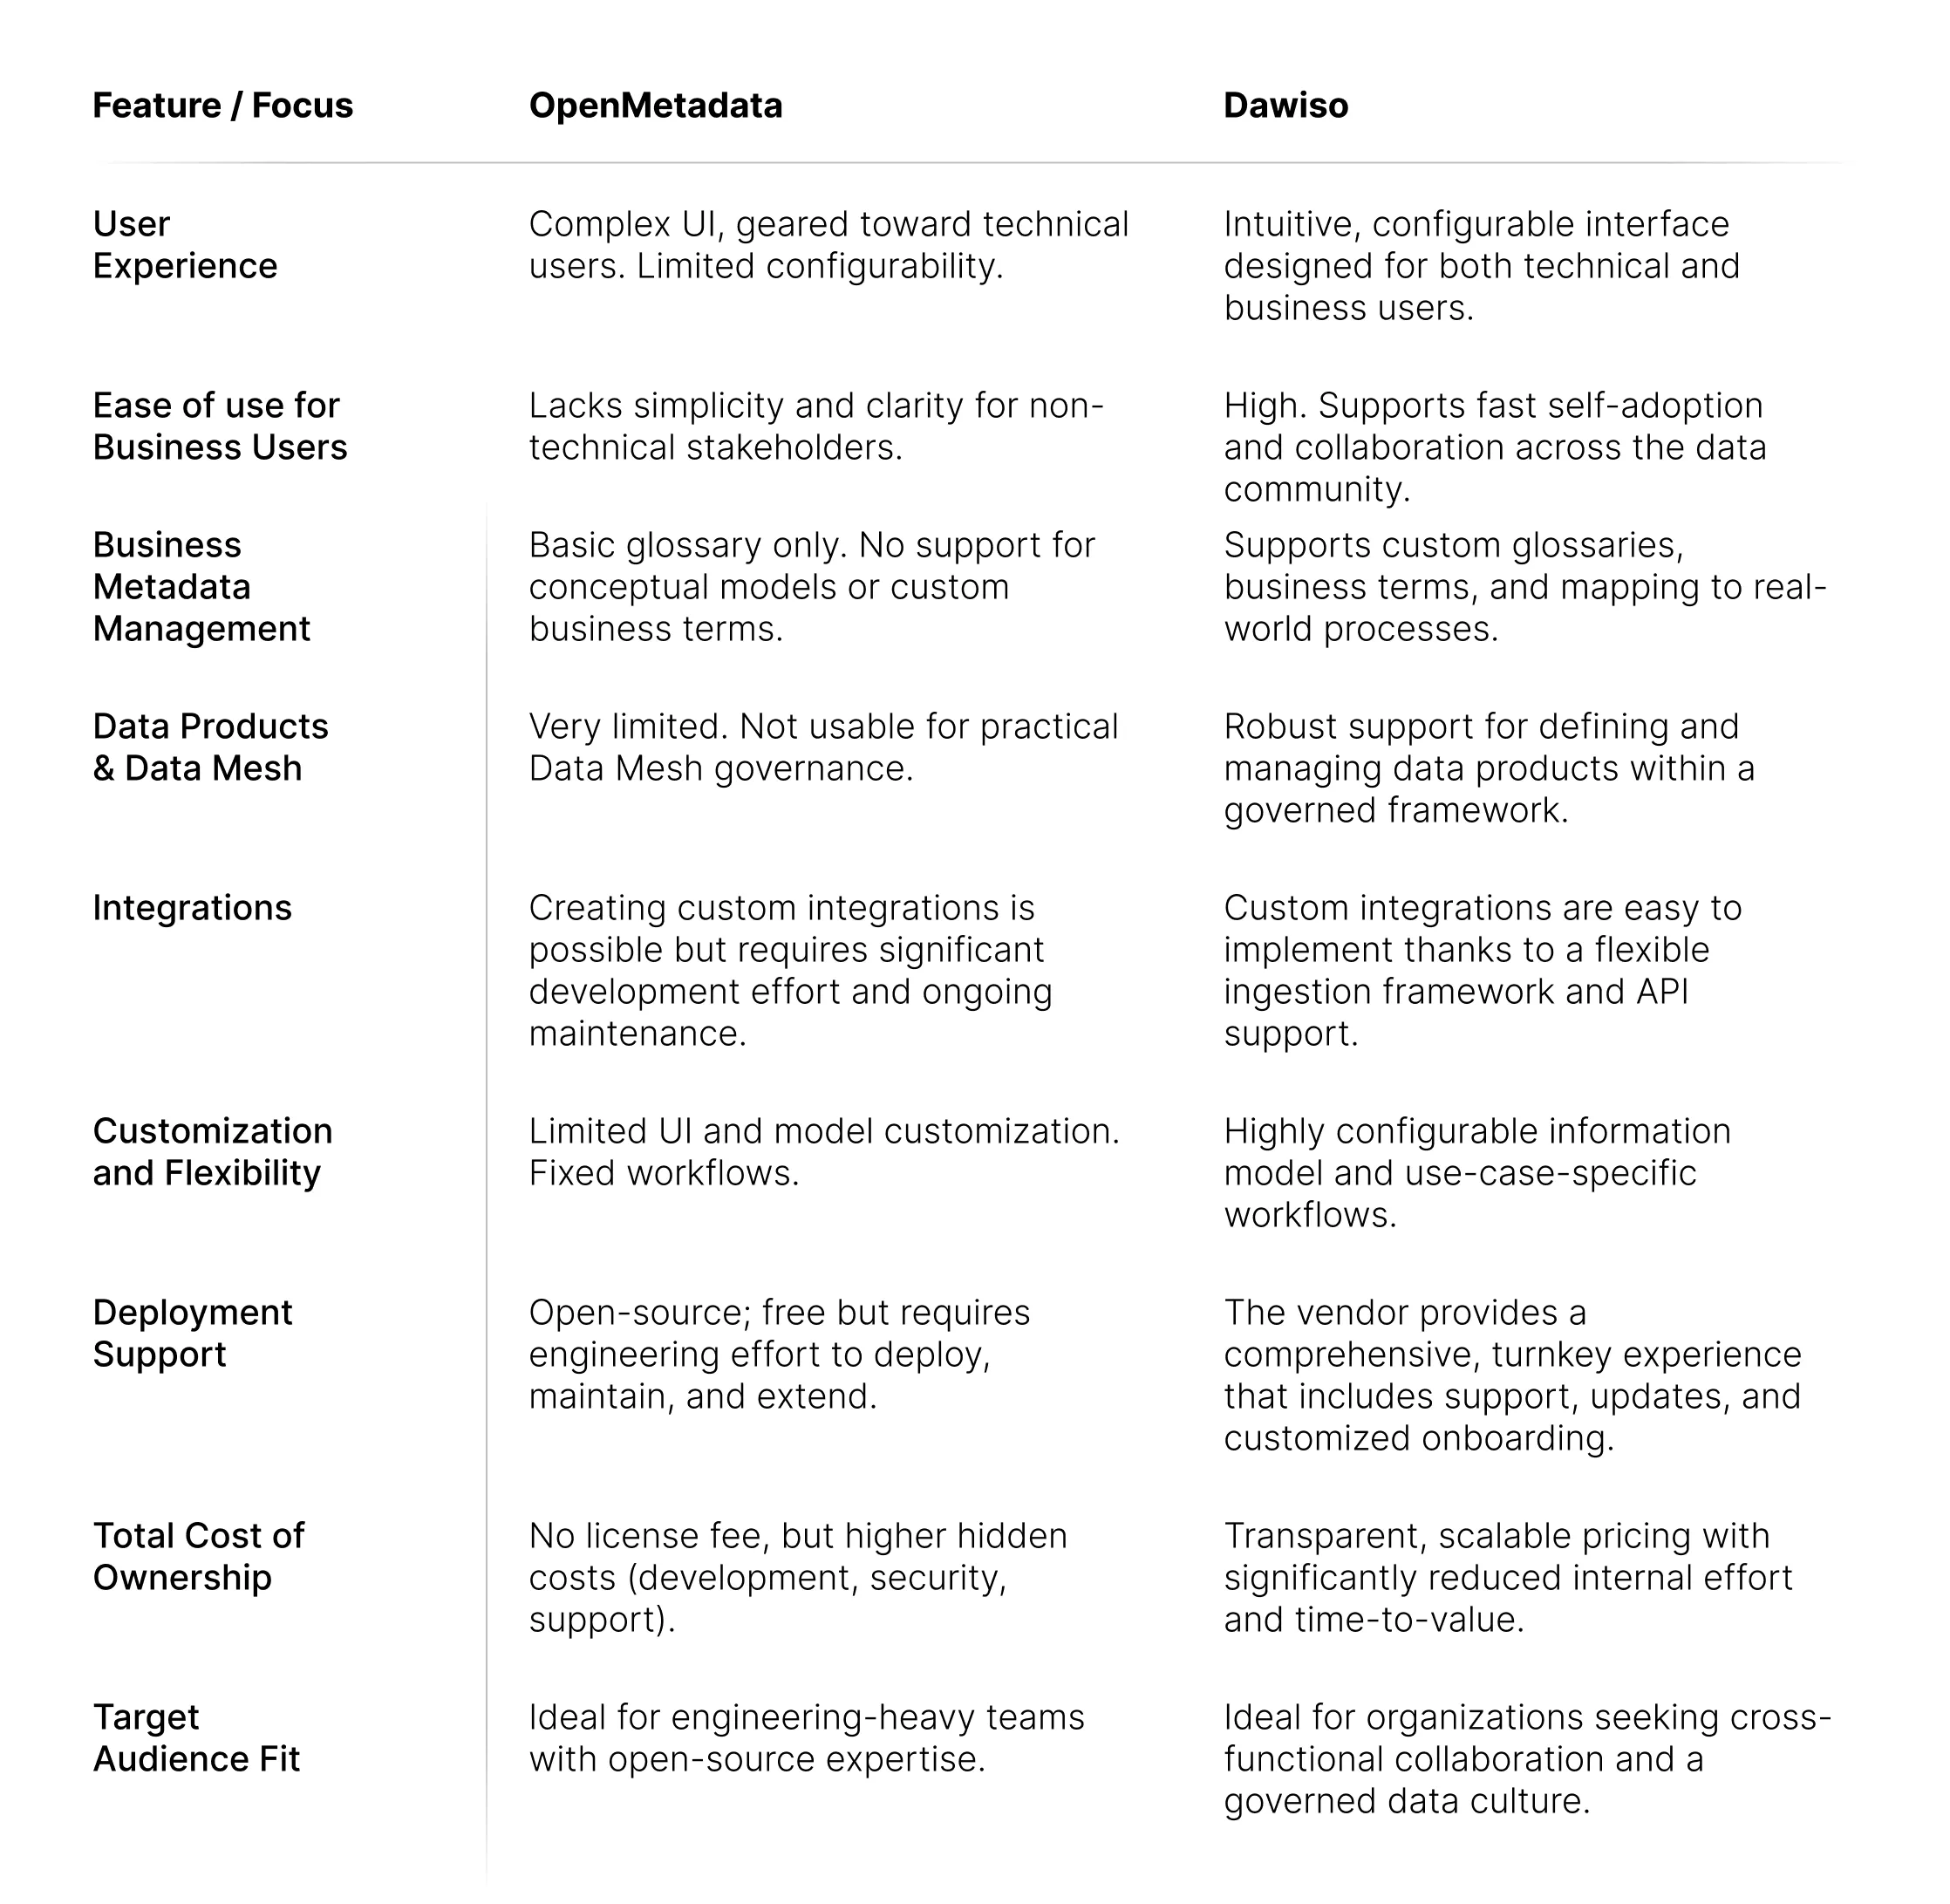
OpenMetadata hat als quelloffene Plattform für Metadaten an Beliebtheit gewonnen, bringt aber mehrere Grenzen mit, die den Einsatz als vollwertiges Datenportal erschweren können, vor allem in Unternehmen, die Technik und Fachbereiche einbinden wollen. Ziehen Sie OpenMetadata in Betracht und suchen nach Alternativen? Sehen wir uns die wichtigsten Unterschiede an, bei der Bedienbarkeit, den Fähigkeiten rund um Metadaten, der Governance von Datenprodukten, den Anbindungen und der Anpassbarkeit insgesamt.
Stärken und mögliche Vorteile von OpenMetadata
OpenMetadata ist ein sich rasch entwickelndes quelloffenes Rahmenwerk für das Management von Metadaten, das unter Data-Engineering-Teams Zuspruch gefunden hat. Es bietet ein flexibles Fundament, um einen Katalog für Metadaten zu bauen, doch seine Stärken sind vor allem technischer Art und gehen mit spürbaren Abwägungen einher.
1. Quelloffenes Fundament (Lizenz Apache 2.0)
OpenMetadata darf kostenfrei genutzt, verändert und weitergegeben werden. Das spricht Unternehmen an, denen Offenheit wichtig ist, die eine Bindung an einen Anbieter vermeiden wollen oder die mit Metadaten experimentieren möchten, ohne vorab Lizenzkosten zu tragen.
Allerdings gilt „kostenfrei“ nur für die Software selbst, nicht für die Kosten von Betrieb, Pflege und Wachstum. Die Einzelheiten dazu unten.
2. Erweiterbare, entwicklerfreundliche Architektur
Der modulare Aufbau und die vorhandenen Schnittstellen (REST und GraphQL) erlauben es geübten Teams, eigene Anbindungen und Pipelines zu bauen oder sogar das Datenmodell zu ändern.
Diese Flexibilität setzt viel technisches Können im eigenen Haus voraus. Eine über die Oberfläche geführte Ebene für die Konfiguration, die auch ohne Entwicklerkenntnisse nutzbar wäre, gibt es nicht.
3. Unterstützung für technische Metadaten
OpenMetadata kann Metadaten aus verbreiteten technischen Quellen wie Snowflake, BigQuery, Redshift, dbt und Kafka einlesen. Es umfasst das Ableiten technischer Lineage, die Versionierung von Schemata, Nutzungsstatistiken und eine grundlegende Profilierung von Daten.
Diese Fähigkeiten sind zwar vorhanden, verlangen aber häufig Konfiguration von Hand, Skripte und Vertrautheit mit den darunterliegenden Schnittstellen für Metadaten. Verglichen mit kommerziellen Katalogen bietet OpenMetadata weniger sofort einsetzbare Konnektoren, wenig über die Oberfläche geführte Einrichtung und weniger Tiefe bei der Anreicherung um fachlichen Kontext, was es eher für Engineering-Teams als für gemischte fachlich-technische Umgebungen geeignet macht.
4. Aktive quelloffene Gemeinschaft
Die Plattform wird aktiv weiterentwickelt, mit regelmäßigen Veröffentlichungen auf GitHub und Austausch in der Gemeinschaft. Meldungen werden vergleichsweise rasch aufgegriffen, und Beitragende können den Fahrplan mitgestalten.
Von einer Gemeinschaft getragen ist nicht dasselbe wie Support auf Unternehmensniveau. Es gibt kein SLA und keine zugesicherte Hilfe, sofern Sie keine Leistungen bei einem Drittdienstleister einkaufen.
5. Betriebsmodelle für die Cloud
Für Docker und Kubernetes entworfen, fügt sich OpenMetadata gut in moderne DevOps-Abläufe ein und unterstützt mitwachsende Umgebungen in Containern. Die erste Einrichtung und der laufende Betrieb verlangen dennoch Wissen über Infrastruktur und Mittel für die Überwachung.
Derzeitige Grenzen von OpenMetadata
Eingeschränkte Bedienbarkeit für Fachbereiche
Die Nutzeroberfläche von OpenMetadata ist mit Blick auf Data Engineers gebaut. Navigation, Diagrammansichten und Anpassungsmöglichkeiten sind für Menschen ohne technischen Hintergrund nicht eingängig. Hinzu kommt, dass die Anpassungsmöglichkeiten sehr begrenzt sind. Das kann die Nutzung in Fachbereichen bremsen, die schnellen, einfachen Zugang zum Kontext ihrer Daten brauchen, ohne dafür geschult zu werden.
Grundlegendes Management fachlicher Metadaten
Die Plattform bietet nur ein einfaches Business Glossary mit begrenzten Möglichkeiten zur Modellierung. Konzeptionelle Modelle, fachliche Regeln oder die Zuordnung eigener fachlicher Begriffe zu technischen Metadaten werden von Haus aus nicht unterstützt, was ein gemeinsames Verständnis von Daten über Abteilungen hinweg erschwert.
Schwache Unterstützung für Datenprodukte und Data Mesh
OpenMetadata unterstützt Datenbestände zwar grundlegend, doch es fehlt das Rahmenwerk für Governance, um Daten als klar beschriebene, wiederverwendbare Produkte zu führen. Das macht es schwer, Verantwortung zu verteilen und Daten als verlässliches Produkt an interne Abnehmer zu liefern.
Eingeschränkte Unterstützung für besondere Anbindungen
OpenMetadata unterstützt viele gängige Datenquellen über eingebaute Konnektoren, doch die meisten verlangen Einrichtung und Konfiguration von Hand statt sofort einsatzbereit zu sein. Das erhöht den Aufwand und die Time-to-Value, besonders in Teams mit knappen Engineering-Ressourcen. Hinzu kommt, dass Anbindungen an Plattformen wie Keboola oder GoodData nicht von Haus aus verfügbar sind und eigens entwickelt werden müssten, was Aufwand bei Einführung und laufender Pflege weiter erhöht.
Versteckte Kosten: Open Source und Datenkataloge von Anbietern
Quelloffene Software mag zunächst kostenfrei wirken, doch ein genauerer Blick fördert häufig erhebliche versteckte Kosten zutage.
1. Entwicklung und Anpassung
Quelloffene Kataloge wie OpenMetadata verlangen Entwicklungsaufwand im eigenen Haus oder extern, für Betrieb, Anbindung von Systemen und den Bau eigener Konnektoren. Ein Eigenbau kann an Personalzeit leicht das 2- bis 3-Fache dessen kosten, was die Einführung eines kommerziellen Produkts kostet, selbst wenn man die Lizenzgebühren einrechnet.
2. Laufende Pflege und Support
Von der Gemeinschaft getragene Aktualisierungen und Fehlerbehebungen haben keine Zusagen aus einem SLA. Sie brauchen eigens abgestellte Entwickler für Korrekturen, Sicherheitsaktualisierungen und Versionswechsel, bei größeren Installationen oft in Vollzeit.
3. Sicherheit, Governance und Compliance
Anders als Lösungen von Anbietern, die gehärtete Sicherheit mitbringen, hängen quelloffene Werkzeuge davon ab, dass Ihr Team oder die Gemeinschaft Schwachstellen, Lizenzänderungen und die Bereitschaft für Prüfungen von sich aus im Griff behält.
4. Lücken im Funktionsumfang und Anbindungen in Einzelteilen
Kommerzielle Kataloge bündeln Konnektoren auf Unternehmensniveau, eine ausgereifte Oberfläche, Automatisierung mit KI und Steuerungsmittel für Governance. Quelloffene Alternativen bringen diese Dinge oft nicht von Haus aus mit, was mehr Entwicklung im eigenen Haus oder zusätzliche Werkzeuge bedeutet.
OpenMetadata verlangt zwar keine Lizenzgebühren, doch der gesamte Entwicklungsaufwand für Einrichtung, Anpassung und Pflege kann zu jährlichen Kosten im sechsstelligen Bereich führen, selbst in mittelständischen Unternehmen in Europa.
Stärken und mögliche Vorteile von Dawiso
1. Nutzerfreundliches Datenportal
Dawiso ist auf breite Nutzung in der gesamten Datengemeinschaft ausgelegt, von Data Engineers bis zu Analystinnen im Fachbereich. Die eingängige Oberfläche bietet einstellbare Ansichten und Diagramme, sodass alle Nutzer sich zurechtfinden, Metadaten verstehen und zu ihnen beitragen können. Man kann also sagen, Dawiso ist ein Datenkatalog für Fachbereiche.
2. Umfassendes Management fachlicher Metadaten
Dawiso bietet ein flexibles Modell für Metadaten, das eigene Business Glossaries, konzeptionelle Modelle und die Zuordnung von Fachlichem zu Technischem unterstützt. Das ermöglicht eine einheitliche Auslegung von Daten und stärkt die Zusammenarbeit zwischen Fachbereich und IT. Die Möglichkeiten zur Anpassung sind auf dem höchsten Niveau unter allen Anbietern.
3. Belastbare Unterstützung für Datenprodukte und Data Mesh
Mit eigenen Fähigkeiten, um Datenprodukte zu beschreiben, zu definieren und zu regeln, hilft Dawiso Unternehmen, moderne Ansätze der Datenarchitektur aufzugreifen. Teams können Datenprodukte innerhalb eines geregelten Rahmens wirksam veröffentlichen, führen und verfolgen.
4. Eingebaute Anbindungen und Flexibilität
Dawiso bietet eine breite Auswahl sofort einsetzbarer Konnektoren, mit denen sich moderne Datenplattformen leicht anbinden lassen, ohne komplexe Einrichtung oder eigene Entwicklung. So kommen Teams schnell an Bord und kümmern sich um Wert statt um Konfiguration. Für anspruchsvollere Fälle unterstützt Dawiso außerdem eigene Wege der Übernahme von Metadaten und den Abgleich mit anderen Katalogen.
Plattformen wie Keboola, GoodData und viele weitere werden nativ unterstützt.
Zur vollständigen Liste der verfügbaren Anbindungen.
5. Für die Cloud gebaut und leicht in Betrieb zu nehmen
Dawiso ist auf einer modernen Architektur für die Cloud gebaut. Es lässt sich in der betreuten Cloud von Dawiso betreiben oder in der eigenen Umgebung des Kunden bei Azure oder AWS. Die Einrichtung geht schnell und verlangt wenig Konfiguration, sodass Teams innerhalb von Stunden mit dem Katalogisieren beginnen, nicht erst nach Wochen. Mehr zum Betrieb in diesem Beitrag.
6. Regelmäßige Aktualisierungen des Produkts
Als Lösung mit einem Anbieter dahinter profitiert Dawiso von einem aktiven Fahrplan für die Entwicklung. Neue Fähigkeiten, Verbesserungen der Bedienbarkeit und aktualisierte Anbindungen erscheinen regelmäßig, auf Grundlage von Rückmeldungen der Nutzer und der Entwicklung in der Data Governance. Diese Aktualisierungen werden automatisch eingespielt, sodass die Umgebung jedes Kunden auf dem neuesten Stand bleibt, ohne Eingriffe von Hand oder zusätzlichen Aufwand.
7. Verlässlicher Kundensupport
Dawiso bietet Support, der rasch antwortet und auf den Bedarf jedes Kunden zugeschnitten ist. Von der Anleitung beim Einstieg über die Fehlersuche bis zum fachlichen Rat sorgt unser Team dafür, dass Unternehmen beim Betrieb oder beim Ausweiten ihres Datenkatalogs nicht allein gelassen werden. Neben dem technischen Support helfen wir Kunden auch, Strukturen für Governance, Modelle für Verantwortung und Rahmenwerke für Datenprodukte zu bestimmen, damit die Plattform zum fachlichen Zusammenhang passt und echten Wert schafft.
Grenzen von Dawiso
Kommerzielles Lizenzmodell
Dawiso ist für viele mittelständische Unternehmen bezahlbar, verlangt aber dennoch eine Lizenzgebühr. Für junge Unternehmen oder Teams ohne Budget für kommerzielle Software kann das eine Hürde sein, verglichen mit kostenfreien quelloffenen Werkzeugen (trotz deren versteckter Kosten).
Auf Bedienbarkeit ausgelegt, nicht auf Eigenbau
Dawiso ist so entworfen, dass es über seine Oberfläche und sein Modell für Metadaten nutzerfreundlich und weitgehend einstellbar ist und damit im ganzen Unternehmen zugänglich bleibt. Es bietet zwar umfangreiche Möglichkeiten zur Anpassung, ist aber keine Plattform für maschinennahe Skripte oder Erweiterungen im Code durch eigene Entwickler. Teams, die ihr Werkzeug vollständig selbst von Grund auf bauen wollen, bevorzugen womöglich ein quelloffenes Rahmenwerk wie OpenMetadata.
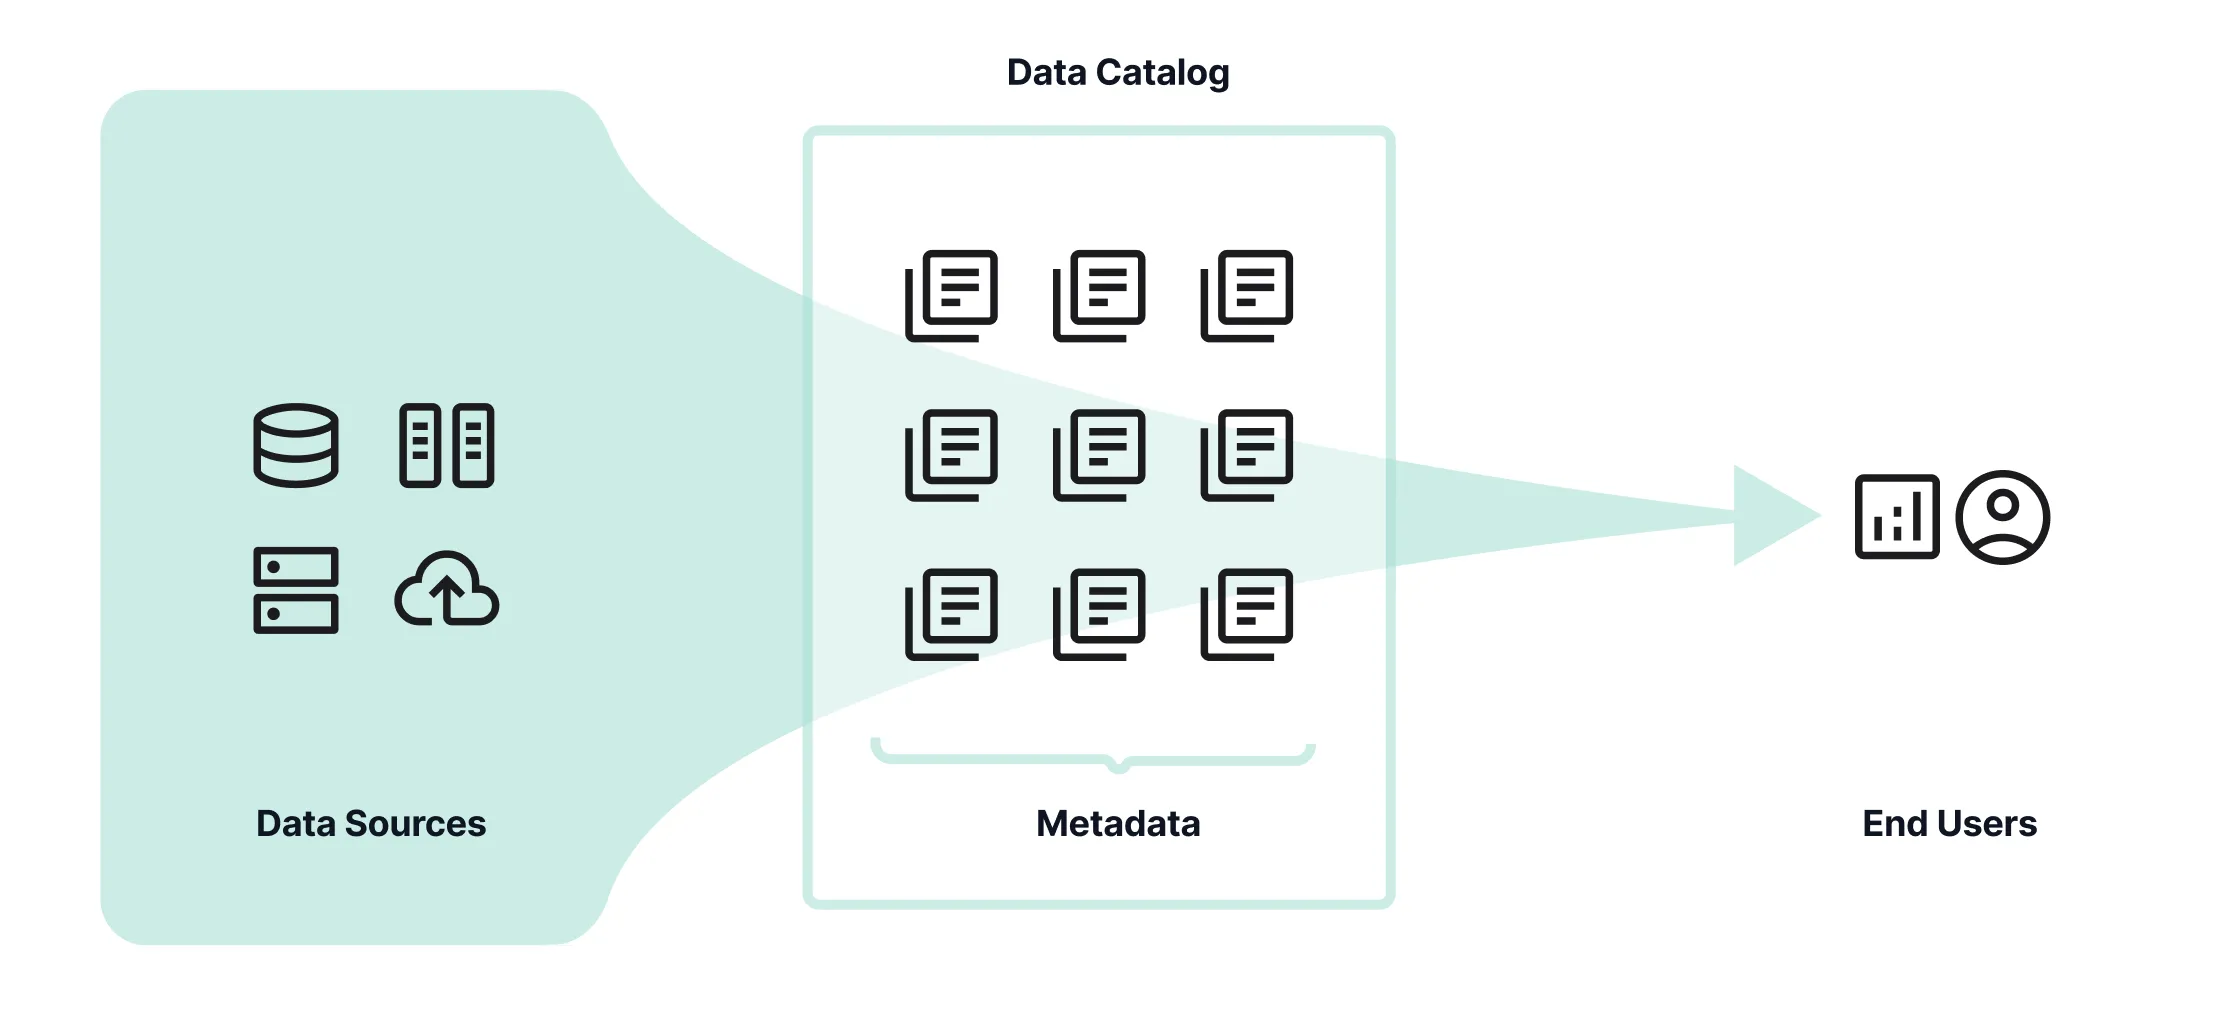
Die Wahl des richtigen Datenkatalogs kann über Ihre Strategie für Data Governance entscheiden. Während der Druck auf Unternehmen wächst, Datenqualität, Nachvollziehbarkeit und Compliance sicherzustellen, ist der Datenkatalog von einem netten Extra zu einem grundlegenden Werkzeug für den Umgang mit Unternehmensdaten geworden. Doch bei so vielen Lösungen am Markt, von quelloffenen Rahmenwerken wie OpenMetadata bis zu von Anbietern betreuten Plattformen wie Dawiso, kann es schwerfallen, die richtige Wahl zu treffen.
Die Wahl des Datenkatalogs ist eine langfristige Festlegung
Die Entscheidung ist nicht nebensächlich. Einen Datenkatalog einzuführen verlangt viel Abstimmung zwischen Teams, und einmal übernommen, ist er tief in technische wie fachliche Abläufe eingebettet. Ihn später zu ersetzen ist weit aufwendiger, als es zunächst scheint. Deshalb ist es entscheidend zu verstehen, worauf es bei der Bewertung Ihrer Möglichkeiten am meisten ankommt: Bedienbarkeit, Mitwachsen, einfacher Betrieb, Automatisierung, Fähigkeiten für Governance und Unterstützung für Ihr Datenökosystem.
So wählen Sie den besten Datenkatalog für Ihr Unternehmen
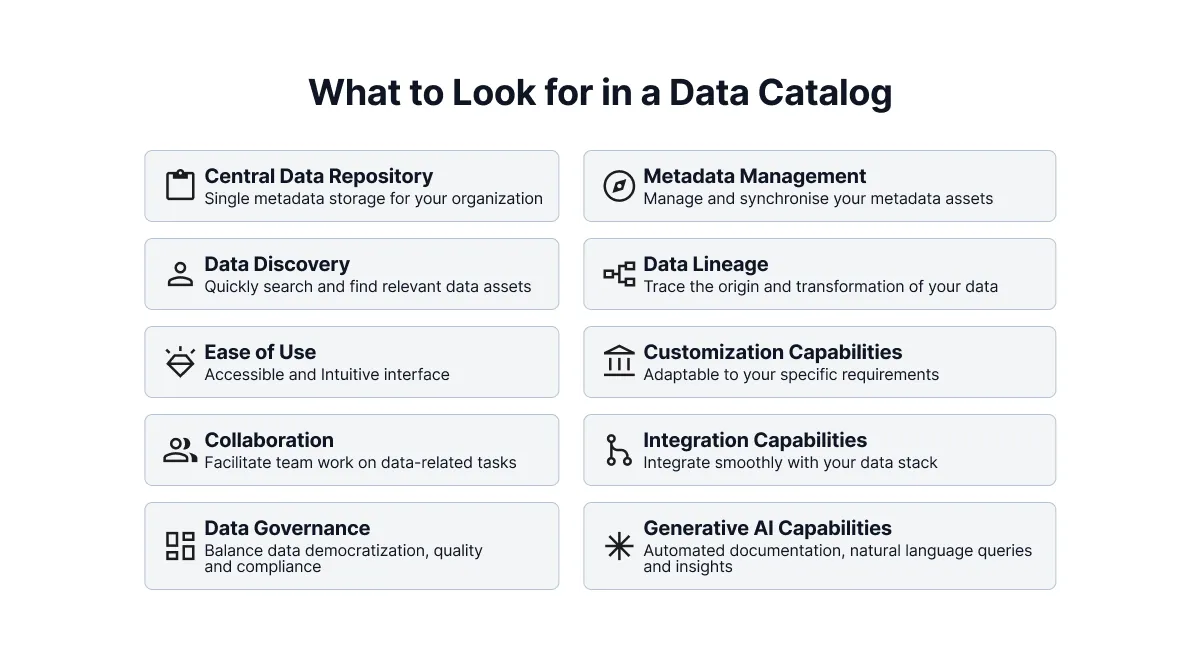
Einen Datenkatalog zu wählen heißt nicht, Häkchen auf einer Funktionsliste zu setzen. Es geht darum, eine Lösung zu finden, die Ihre Datenstrategie unterstützt, zum Reifegrad Ihres Teams passt und sich in Ihr bestehendes Ökosystem fügt. Hier sind einige der wichtigsten Gesichtspunkte:
Einfache Bedienung
Ein Datenkatalog sollte nicht nur für Data Engineers zugänglich sein. Achten Sie auf eine Nutzeroberfläche, mit der Technik und Fachbereiche Metadaten leicht finden, verstehen und ergänzen können. Je eingängiger die Plattform, desto höher die Nutzung über die Teams hinweg, und desto besser gelingt die Datendemokratisierung.
Anpassbarkeit
Jede Branche und jedes Unternehmen hat eigene Begriffe, Abläufe und Strukturen. Ein flexibler Datenkatalog lässt Sie Modelle für Metadaten, Nutzerrollen und Abläufe so zuschneiden, wie Ihre Teams tatsächlich arbeiten, statt Sie zur Anpassung an das Werkzeug zu zwingen.
Fähigkeiten für Data Governance und Compliance
Während die Erwartungen der Aufsicht steigen, sollte Ihr Katalog mehr tun, als Metadaten zu ordnen. Er sollte Abläufe für Governance, Modelle für Verantwortung, Zugriffskontrolle und Audit-Trails unterstützen. Diese Fähigkeiten helfen dafür zu sorgen, dass Ihre Datenbestände über die Zeit vertrauenswürdig und regelkonform bleiben.
Automatisierung und Fähigkeiten für KI
Metadaten von Hand zu dokumentieren und zu pflegen kostet Zeit und ist fehleranfällig, und ein großer Teil der Arbeit in der Data Governance geschieht noch immer von Hand. Etwa Objekte zu kennzeichnen, Status zu aktualisieren und Verantwortliche zuzuweisen. Das kostet Zeit, wiederholt sich und lässt sich von Teams oft schlicht nicht vollständig von Hand erwarten. Plattformen, die Automatisierung und KI nutzen, können diese Last deutlich verringern, indem sie Metadaten selbst entdecken, selbst kennzeichnen, eigene Abläufe automatisieren und Beziehungen vorschlagen, was Ihrem Team Zeit spart und zugleich die Genauigkeit erhöht.
Eingebaute Anbindungen
Ein moderner Katalog sollte sich reibungslos mit den Werkzeugen Ihrer Datenlandschaft verbinden. Plattformen für ETL, Data Warehouses, BI-Werkzeuge und mehr. Starke eigene Anbindungen bedeuten eine glattere Einführung, schnelleren Nutzen und weniger Aufwand für die Pflege.
Mitwachsende Preise
Wenn Ihr Datenbestand wächst, wächst auch Ihr Bedarf an umfassendem Management von Metadaten. Wählen Sie einen Katalog mit transparenten, mitwachsenden Preisen, der Ihnen nicht im Weg steht, wenn sich Ihr Bedarf verändert. Das ist besonders für kleinere Teams oder rasch wachsende Unternehmen entscheidend. Die Preise von Dawiso finden Sie hier.
Bei Werkzeugen mit einem Anbieter dahinter richten sich die Preise meist nach Nutzung, Nutzern oder Funktionsumfang und schließen Support, Aktualisierungen und zugesicherte Dienstgüte ein. Quelloffene Werkzeuge wie OpenMetadata sind dagegen technisch kostenfrei nutzbar, was aber nicht heißt, dass sie keine Kosten verursachen. Sie werden voraussichtlich eigene Mitarbeitende oder externe Beratung brauchen, um das System zu betreiben, einzurichten, zu pflegen und abzusichern. Für Unternehmen mit starkem eigenem Engineering kann das reizvoll sein, andere stellen womöglich fest, dass Lösungen mit einem Anbieter dahinter auf lange Sicht besser planbare und wirtschaftlichere Gesamtkosten bieten.
Umfassender Support
Selbst die besten Werkzeuge bringen eine Lernkurve mit. Der Support des Anbieters, die Güte der Dokumentation und der Zugang zu einem schnell reagierenden Helpdesk oder einer Gemeinschaft können einen großen Unterschied machen, wie erfolgreich Ihre Einführung verläuft und wie schnell Ihr Team Nutzen aus dem Katalog zieht.
Zusammenfassung
OpenMetadata ist eine solide Wahl für Teams mit starkem technischem Können und einer Vorliebe für Open Source, kann aber für Unternehmen zu kurz greifen, die Fachbereiche einbinden, Datenprodukte führen und ein umfassendes Datenportal mit wenig Engineering-Aufwand bauen wollen.
Für alle ohne eigene Engineering-Kapazität oder ohne die Bereitschaft, eine eigene Schicht für Metadaten zu bauen und zu pflegen, bietet eine von einem Anbieter betreute Plattform womöglich den tragfähigeren und fachlich passenderen Weg.
Dawiso bietet eine zugänglichere, für Governance bereite Alternative, mit der Unternehmen ihre Arbeit an Metadaten über das gesamte Unternehmen ausweiten und dabei Transparenz, Verantwortung und Vertrauen in Daten stärken.
Wenn Sie weitere Kataloge vergleichen möchten, sehen Sie sich unseren Leitfaden zum Vergleich von Datenkatalogen an.
Häufige Fragen
Worin unterscheiden sich OpenMetadata und Dawiso?
OpenMetadata ist eine quelloffene, auf Entwickler ausgerichtete Plattform für Metadaten, während Dawiso ein von einem Anbieter betreuter, fachlich zugänglicher Datenkatalog mit starken Fähigkeiten für Governance und Anbindungen ist.
Ist OpenMetadata kostenfrei nutzbar?
Quelloffene Werkzeuge wie OpenMetadata sind technisch kostenfrei nutzbar, was aber nicht heißt, dass sie keine Kosten verursachen. Also ja, aber nur die Software. Kosten entstehen durch Betrieb, Anpassung und langfristige Pflege.
Eignet sich Dawiso für kleine oder mittelständische Unternehmen?
Ja. Dawiso bietet mitwachsende Preise, einfachen Betrieb und eingängige Fähigkeiten, die es für mittelständische Teams zu einer starken Wahl machen, die ihre Data Governance verbessern wollen.
Kann Dawiso OpenMetadata im Unternehmenseinsatz ersetzen?
Ja. Dawiso bringt Fähigkeiten für fachliche wie technische Nutzer mit, belastbare Möglichkeiten zur Anbindung und Unterstützung für Datenprodukte, also Bereiche, in denen OpenMetadata umfangreiche Eigenentwicklung verlangen kann.