4 Wochen Migration, 2 Wochen für eine neue Arbeitsweise
Was der Neubau von dawiso.com in Code freigesetzt hat und warum wir aufgehört haben, ein CMS zu planen. Vor acht Wochen haben wir die Migration gestartet. Vier Wochen später gingen wir live: 240 Seiten, 536 Commits, 40 Komponenten, die ganze Website von Grund auf neu in Code gebaut. Die Zahlen fühlten sich wie die Pointe an. Sie waren es nicht. Sie waren die Vorbereitung.
Die Beschleunigung, die wir nicht geplant hatten
Was in den vier Wochen nach dem Go-live geschah, ist die eigentliche Geschichte. Und der Teil, der für alle zählt, die 2026 eine KI-ready Marketing-Maschine aufbauen wollen.
Als wir die neue Website ausgeliefert haben, sah unser interner Plan vor, darauf ein „leichtes CMS“ zu bauen: eine einfache Verwaltungsschicht für das Marketingteam, damit es keinen Code anfassen muss. Ein vernünftiger Plan. Standard-Vorgehen.
Wir haben es nie gebaut.
Innerhalb von zwei Wochen nach dem Go-live merkten wir, dass das Marketingteam aufgehört hatte, danach zu fragen. Nicht, weil es den Entwicklungsprozess hinnahm. Sondern weil es mittendrin war. Jede und jeder hatte einen eigenen Feature-Branch angelegt, schob Änderungen hoch und sah zu, wie sich die eigene Preview-URL in wenigen Minuten aktualisierte.
Keine Warteschlange. Kein „schick es an die Entwicklung“. Kein Warten auf Kapazität im Sprint.
Wir sind ein Unternehmen mit 30 Leuten. Das Marketingteam ist klein. Und innerhalb von zwei Wochen nach dem Go-live verschob sich der Durchsatz auf eine Weise, die keiner von uns erwartet hatte.
Die Belege
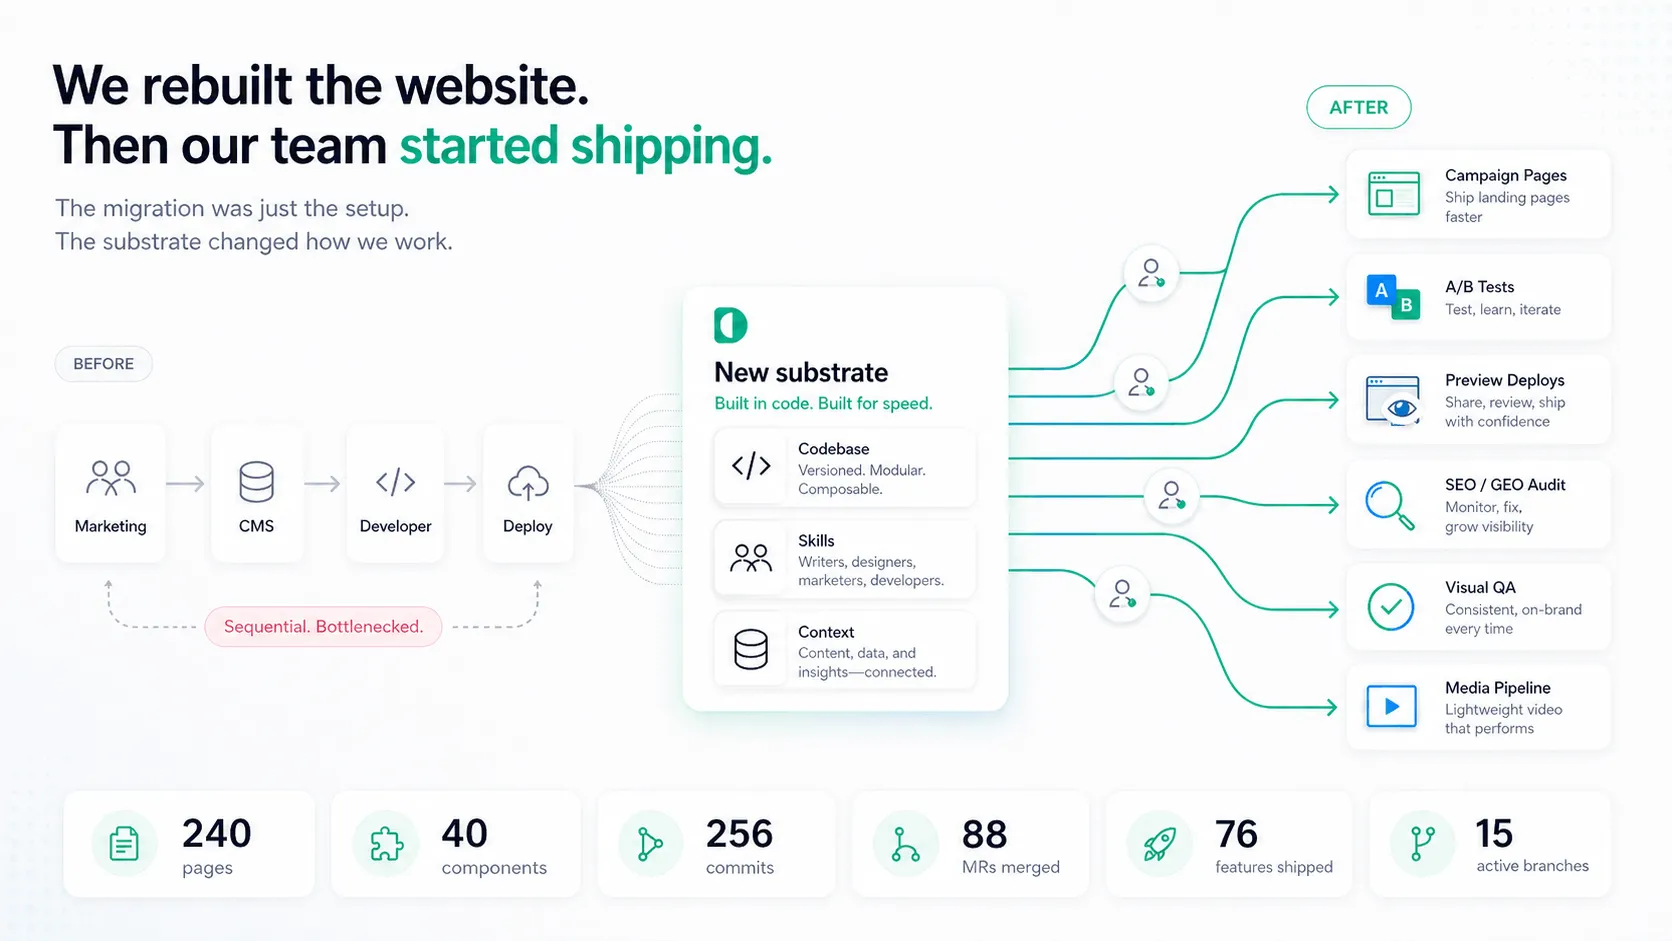
In den vier Wochen nach dem Go-live verzeichnet das Deployment-Repository 256 Commits, 88 gemergte Merge Requests und 76 ausgelieferte Features. 15 Branches sind heute in aktiver Entwicklung.
Eine Anmerkung zum Begriff: Wenn wir in diesem Artikel von „Infrastruktur“ sprechen, meinen wir die Schicht unter der Arbeit: die Codebasis, die Preview-Branches, die Skills, die Dokumentation und den Kontext, die bestimmen, wie schnell sich das Team bewegen kann. Die Migration hat die Infrastruktur verändert. Alles Weitere folgt daraus.
A/B-Tests kamen von der Roadmap in die Produktion
Das stand das ganze Jahr 2025 auf unserer Roadmap. Es ist die Art von Projekt, die einfach klingt, bis man anfängt: Instrumentierung, Aufteilung des Datenverkehrs, statistische Signifikanz, Integrationen mit unseren Werkzeugen für Kampagnen. Jedes Quartal sagten wir „diesmal klappt es“. Jedes Quartal gewann etwas anderes den Kampf um die Priorität.
Nach der Migration haben wir es in einer Woche ausgeliefert. Zwei Landingpages bekamen 13 Tage nach dem Go-live A/B-Varianten: Context Layer und Data Catalog. Sie laufen jetzt und optimieren auf Conversion. Was wir in zwölf Monaten nicht geschafft hatten, dauerte fünf Arbeitstage, sobald sich die Infrastruktur geändert hatte.
Der Engpass war nicht die Kapazität und nicht die Priorität. Es war die Reibung. Sobald wir die Reibung beseitigt hatten, geschah Arbeit, die ein Jahr lang aufgeschoben worden war, in der normalen Arbeitszeit.
Die Arbeit im Marketing wurde parallel
Jede Person im Marketingteam kann einen Branch anlegen, Änderungen auf der ganzen Website vornehmen und eine Live-Preview-URL zur Prüfung mit dem Rest des Teams teilen. Drei Leute können gleichzeitig an drei verschiedenen Kampagnen arbeiten, jede mit eigener Preview, ohne sich gegenseitig zu blockieren.
Früher brauchte das mindestens eine Entwicklerin oder einen Entwickler je aktiver Kampagne.
„Heute ist der Entwickler die Infrastruktur, keine Person.“
Skills ersetzten die CMS-Schicht
Ein CMS ist eine Schicht, mit der man bestimmte Dinge tun kann, die die Entwicklung freigegeben hat. Wir haben eine andere Schicht: benannte Skills, im Projekt definiert, die das Team auslöst. Ein paar Beispiele:
/new-product-pageerzeugt aus einem Briefing eine neue Produktseite/new-componententwirft und baut eine neue Astro-Komponente/new-glossary-page,/new-news-page,/new-event-pagefür das Anlegen typisierter Inhalte/geo-auditführt eine vollständige Prüfung von SEO und KI-Zitierbarkeit durch/meta-descriptionsprüft Meta-Beschreibungen und schreibt sie neu/visual-qaprüft das Erscheinungsbild nach Änderungen/deployliefert ein Preview-Deploy auf einen Feature-Branch aus
Sechzehn davon gibt es heute im Projekt. Sie werden einmal definiert, von allen ausgeführt und decken ab, was ein CMS abdecken würde, und dazu Dinge, die kein CMS anfassen würde: Audits, Refactoring, die strukturierte Erkundung von Designentscheidungen.
Ein CMS wäre ein System gewesen, das wir pflegen müssten. Die Skills sind ein System, das wir nutzen.
Die Medienproduktion wurde zur Pipeline
Dasselbe Muster, ein anderer Bereich. Bilder und Videos bedeuteten früher, eine Designerin zu briefen oder ein Team zu beauftragen. Heute betreiben wir Pipelines.
Unser erstes Anleitungsvideo erscheint bald: ein generatives Videomodell von Google für die Bilder, ElevenLabs für die Sprecherstimme, Claude, das das Ganze orchestriert. Wir haben kein Videoteam aufgebaut. Wir haben eine Video-Pipeline aufgebaut. Bilder gehen denselben Weg. Weniger Tickets an eine Designerin, mehr Agenten, die auf Basis unseres Markenkontexts produzieren.
Der Pavel-Test
Vor zwei Monaten haben wir einen neuen Frontend-Entwickler eingestellt. Als er sich vorstellte, lief unser Stack auf Webflow. Als er im April anfing, war Webflow weg und die Website lief auf Astro, Tailwind und einer eigenen CI/CD-Pipeline.
So hatte er noch nie gearbeitet. Das Vorstellungsgespräch hatte sich um einen Job gedreht, den es nicht mehr gab.
Nach drei Wochen sagte er mir, es sei magisch. Das Beste, was ihm hätte passieren können.
Wir erwähnen das, weil es der stärkste Beleg ist, den wir dafür haben, dass das keine Geschichte von einem CEO am Wochenende ist. Die Beschleunigung ist nicht denen vorbehalten, die die Infrastruktur gebaut haben. Wer in die Infrastruktur hineingeht, bekommt sie.
Sein Name ist Pavel Ďuriš. Drei Wochen Ergebnisse: eine Neugestaltung der Preisseite, eine Überarbeitung der Seite für Konnektoren und ein SEO/GEO-Durchgang über unsere 16 wichtigsten Seiten. Keine Commits eines Einsteigers. Auslieferung auf Teamniveau, auf einem Stack, den er vor April nie benutzt hatte.
Die Wirtschaftlichkeit hat sich verändert
Die Infrastruktur unter dem Marketingteam hat sich verändert. Alles andere folgt daraus. A/B-Tests in einer Woche. Parallele Arbeit an Kampagnen. Eine Video-Pipeline, die ausliefert. Alles kam aus derselben Veränderung.
Aus einem Jahr „wir wollen A/B-Tests machen“ wurde eine Woche, in der wir sie gemacht haben.
Parallele Kampagnen gingen von „braucht eine Entwicklerin“ zu „braucht einen Branch“.
Ein CMS, das, was wir bauen wollten, erwies sich als Lösung für ein Problem, das wir nicht mehr hatten.
Seiten, Komponenten, Audits, Meta-Beschreibungen, Deploys: Vor sechs Monaten war jedes davon ein eigenes Projekt. Heute sind es Skills. Alle führen sie aus.
„Das ist das eigentliche Rewrite. Nicht die Website. Die Rechnung dahinter, was ein kleines Team ausliefern kann.“
Wie es weitergeht
Wir kündigen kein CMS an. Wir arbeiten an etwas anderem: Agenten, die unsere Marketingdaten lesen und konkrete Verbesserungen vorschlagen. Leistung von Kampagnen. Webanalyse. Signale zur Conversion. Die Vorschläge gehen in den Code der Website, in die Kampagnen selbst und irgendwann in unsere Vertriebsmaschine, sodass derselbe Kontext bis zu den Menschen fließt, die abschließen.
Was wir gerade testen: Agenten, die Kampagnendaten lesen und Änderungen an Seiten als Pull Requests vorschlagen. Echte Diffs. Prüfbar. Mergebar. Das Marketingteam prüft Vorschläge, statt Tickets zu schreiben.
Das schwierigere Problem darunter: In dem Moment, in dem man Agenten auf Marketing- und Vertriebsdaten handeln lässt, braucht man Governance darum herum. Woher jede Zahl stammt. Mit welcher Kampagne sie verbunden ist. Wem die Definition der Kennzahl gehört. Was sich seit gestern geändert hat. Ohne das halluzinieren Agenten entweder oder bleiben zu eng, um etwas zu bewirken.
Hier wurden wir unser eigener Kunde. Unser Geschäft ist eine Plattform für Data Governance. Wir nutzen sie, um unsere eigenen Marketing- und Vertriebsdaten den Agenten zugänglich zu machen, die wir bauen, mit intakter Lineage, Zuständigkeit und Definitionen. Die Agenten lesen keine rohen Tabellen. Sie lesen einen geregelten Katalog: Definitionen, Zuständigkeit, Lineage und den Kontext hinter jedem Signal.
Das ist dasselbe Problem, vor dem unsere Kunden im Enterprise-Umfeld von der anderen Seite stehen. KI-Agenten sind nur nützlich, wenn sie auf vertrauenswürdigem Kontext handeln können: Definitionen, Zuständigkeit, Lineage, Berechtigungen und aktuelle Signale. Diese These wenden wir jetzt auf unsere eigene Marketing-Maschine an.
Ein nützlicher Nebeneffekt für ein Produktunternehmen: Wenn man die eigene Plattform für etwas so Neues nutzt, findet man heraus, was man als Nächstes bauen sollte. Wir sehen Lücken, auf die noch kein Kunde gestoßen ist, weil noch kein Kunde das versucht hat. Die Produkt-Roadmap wird in Echtzeit von unserem eigenen Anwendungsfall geformt.
Das ist der nächste Artikel. Wir schreiben ihn, wenn die Daten ihn rechtfertigen.
Warum der Kontext zum eigentlichen Fundament wurde
Ein Muster, auf das wir immer wieder zurückkommen: Je agentischer wir arbeiten, desto mehr stützen wir uns auf die Qualität des Kontexts, den wir hineingeben. Die Skills sind dokumentiert. Die Markenstimme ist dokumentiert. Die Designsprache der Website ist dokumentiert. Die Komponentenbibliothek ist typisiert. Wenn ein Agent eine neue Produktseite ausliefert, improvisiert er nicht. Er arbeitet einen Bestand an Kontext ab, den das Team aufgebaut hat.
Besserer Kontext → bessere agentische Arbeit → mehr Auslieferung → mehr Kontext, der geregelt werden muss. Unser Geschäft ist eine Plattform für Data Governance, und wir entdecken an uns selbst, warum sie das Fundament ist, für das wir sie gehalten haben.
Vor acht Wochen wollten wir eine Website ersetzen. Vier Wochen später war sie live. Zwei Wochen danach merkten wir, dass wir etwas Größeres ersetzt hatten: die Art, wie unser Marketingteam ausliefert.