RAG vs. Semantic Layer: Wo liegt der Unterschied?
Enterprise-KI braucht Kontext, um genaue und belastbare Antworten zu geben. Doch zwei zentrale Ansätze, diesen Kontext zu liefern, werden bis heute verwechselt: RAG (Retrieval-Augmented Generation) und der Semantic Layer. Wer wirksame KI-Systeme bauen will, muss wissen, wann RAG passt, wann ein Semantic Layer nötig ist und worin sich beide unterscheiden.
Sowohl RAG als auch ein Semantic Layer sind Wege, einer KI Kontext zu liefern. Das ist die Grundlage, um ihr Verhältnis zu verstehen. Im Prinzip arbeiten sie ähnlich: Ein Chatbot oder KI-Agent bindet entweder RAG oder einen Semantic Layer an, um passende Informationen abzurufen. Der entscheidende Unterschied liegt darin, mit welcher Art von Daten sie umgehen und wie sie diesen Kontext bereitstellen.
Was ist RAG (Retrieval-Augmented Generation)?
Wenn im KI-Umfeld von RAG die Rede ist, geht es in erster Linie um RAG als Technologie, also um einen bestimmten Ansatz, Informationen mithilfe von Vektordatenbanken zu speichern und abzurufen. Davon zu unterscheiden ist die RAG-Architektur, ein umfassenderes System, das die RAG-Technologie zusammen mit weiteren Bausteinen einsetzt.
RAG als Technologie: die Kernbausteine
Im Kern besteht die RAG-Technologie aus drei grundlegenden Bausteinen:
- Vektordatenbank mit Embeddings
- Suchmaschine (Ähnlichkeitssuche über Vektoren)
- Embedding-Strategie (wie die Datenbank befüllt wird)
Embeddings verstehen
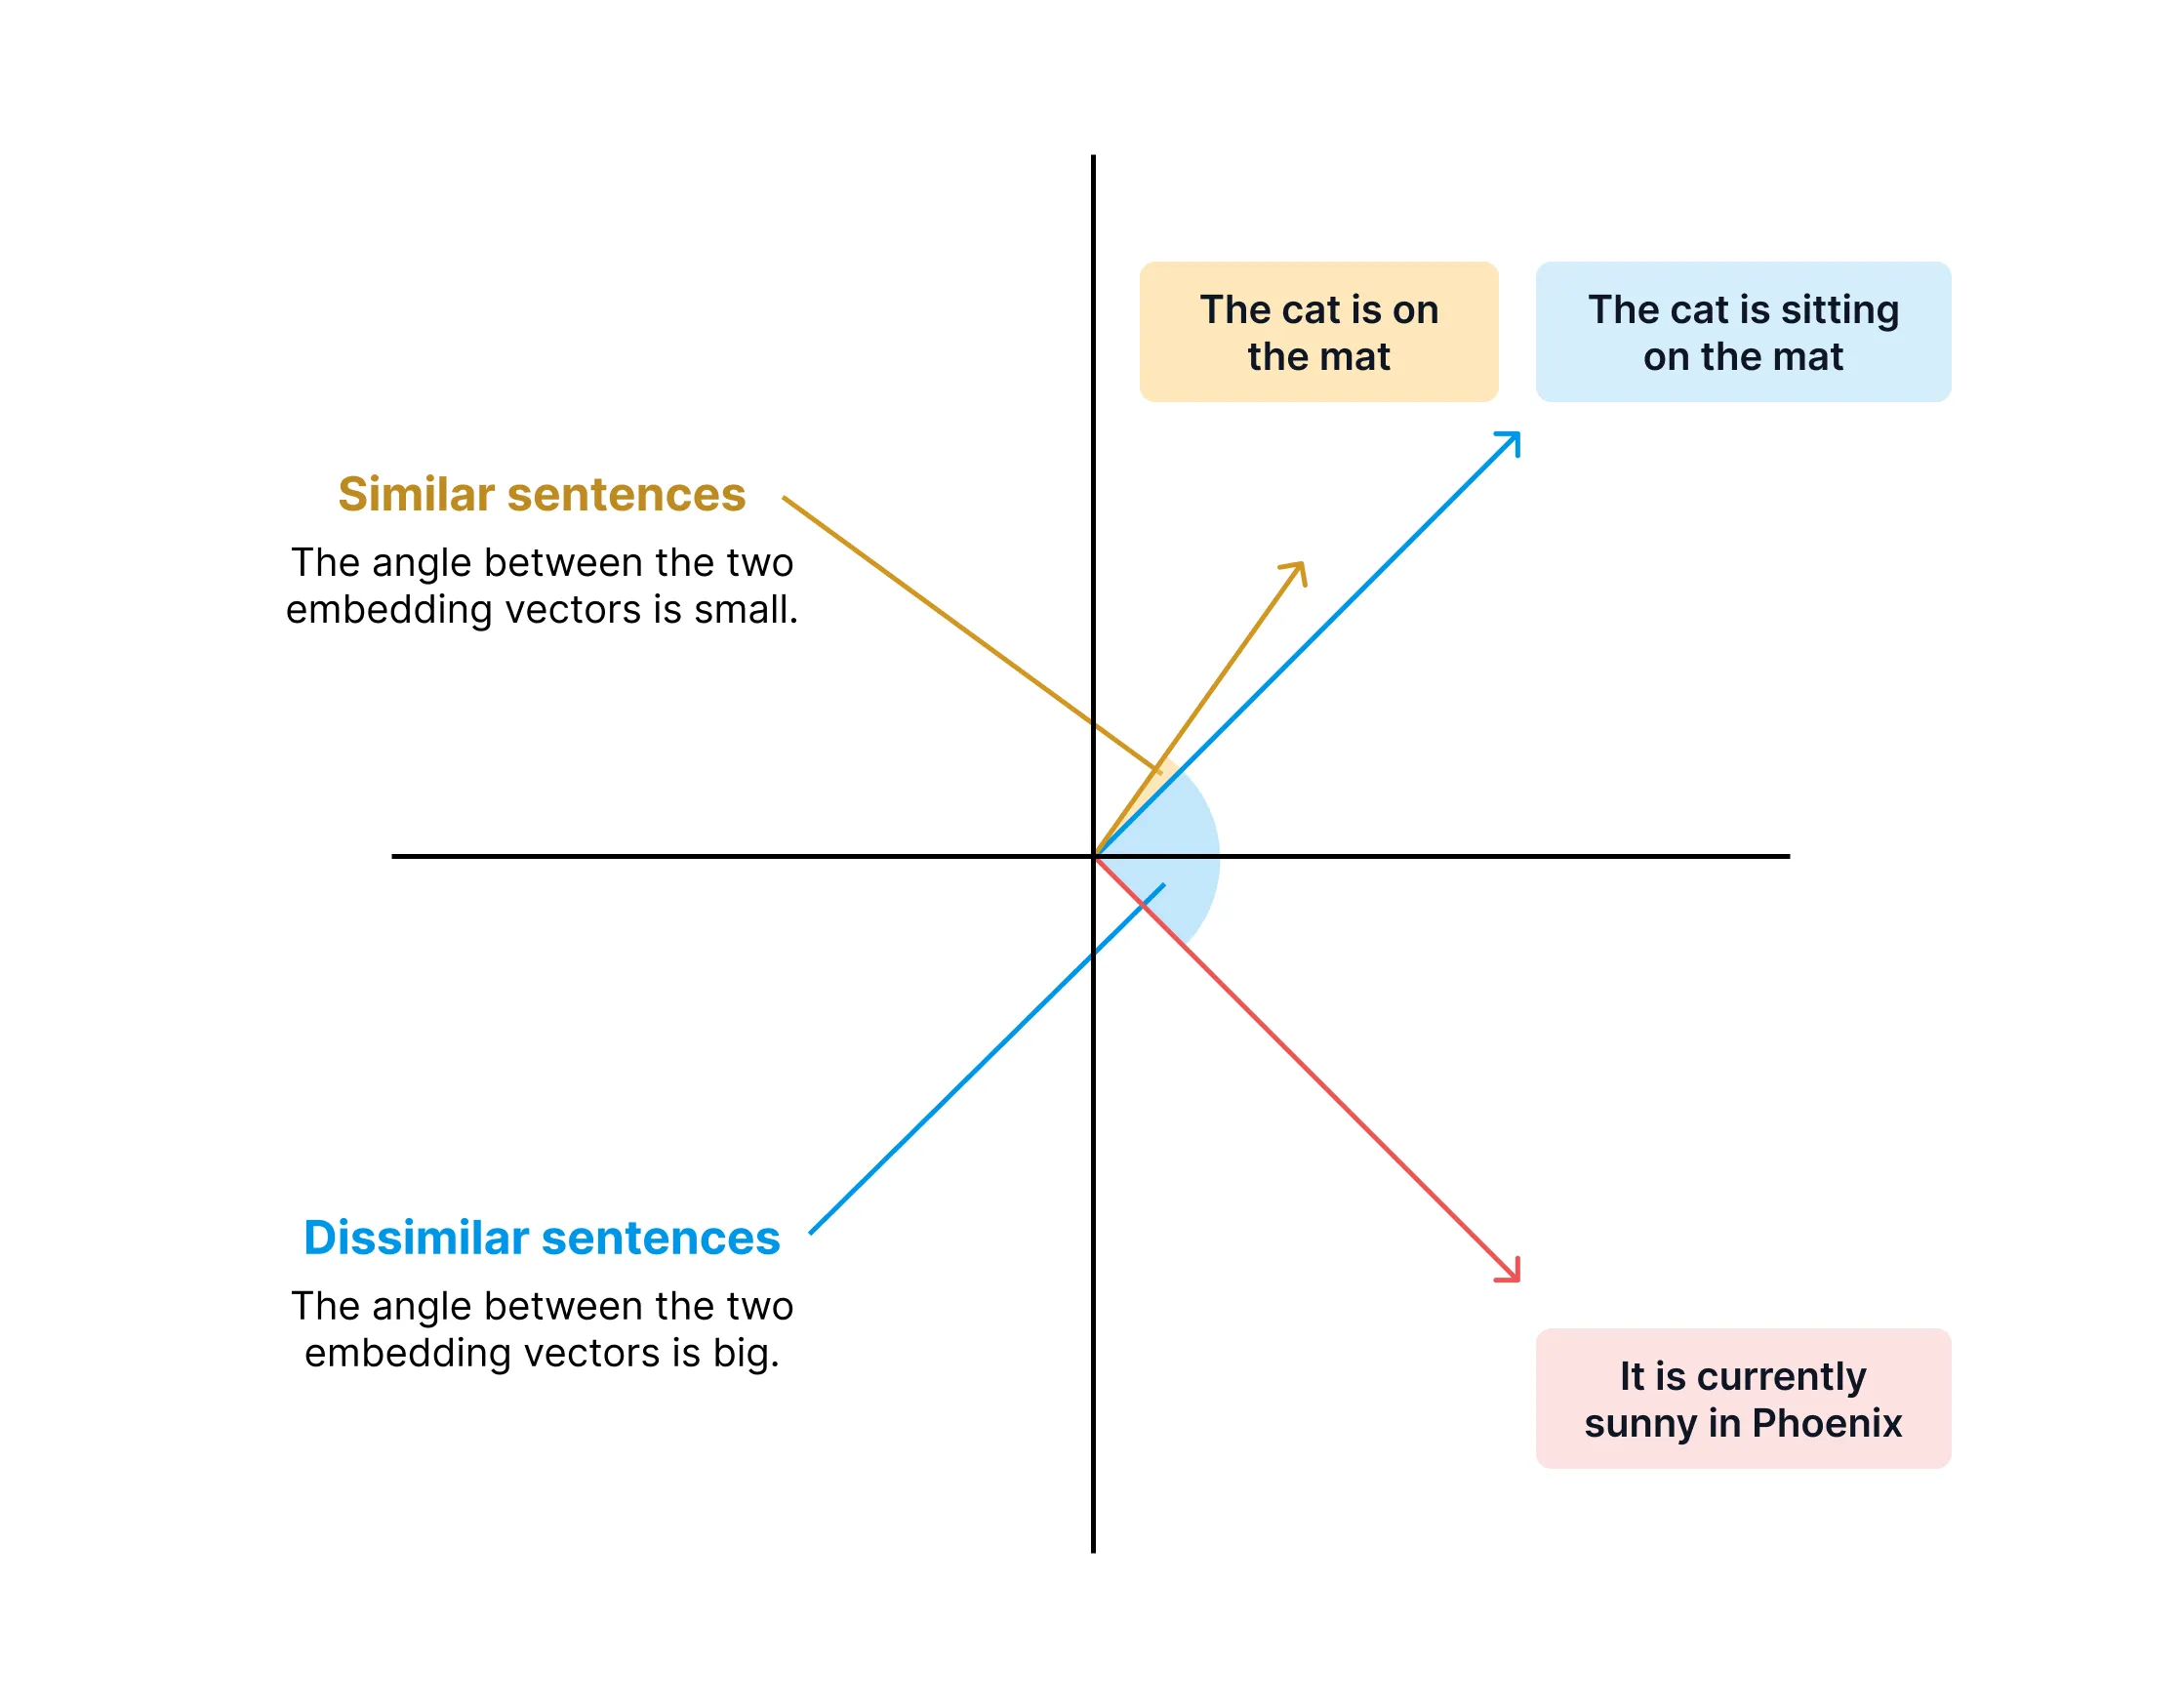
Embeddings sind das Fundament der RAG-Technologie. Ein Embedding ist im Kern ein Textabschnitt, der in eine numerische Vektordarstellung überführt wurde. Entscheidend ist die Strategie, nach der Embeddings entstehen:
Embeddings erzeugen:
- ein Quelldokument nehmen (etwa einen Bericht mit 30 Seiten)
- es nach verschiedenen Strategien in kleinere Chunks zerlegen:
- nach Sätzen
- nach Absätzen
- nach Kapiteln oder logischen Abschnitten
- nach Satzzeichen
- nach fester Zeichenzahl (etwa 150 Zeichen)
- …
- Jeder Chunk wird zu einem eigenen Eintrag in der Vektordatenbank
- Für jeden Chunk wird ein Vektor berechnet (eine mehrdimensionale Zahl)
So funktioniert der Abruf bei RAG:
- Trifft eine Anfrage der KI ein, wird für diese Anfrage ein Vektor berechnet
- Dieser Anfragevektor wird mit allen Embedding-Vektoren in der Datenbank verglichen
- Gesucht werden die Embeddings mit dem kürzesten Vektorabstand, also der besten Übereinstimmung
- Die passendsten Textabschnitte werden zurückgegeben
- Diese Abschnitte gehen an das LLM, das daraus die Antwort erzeugt
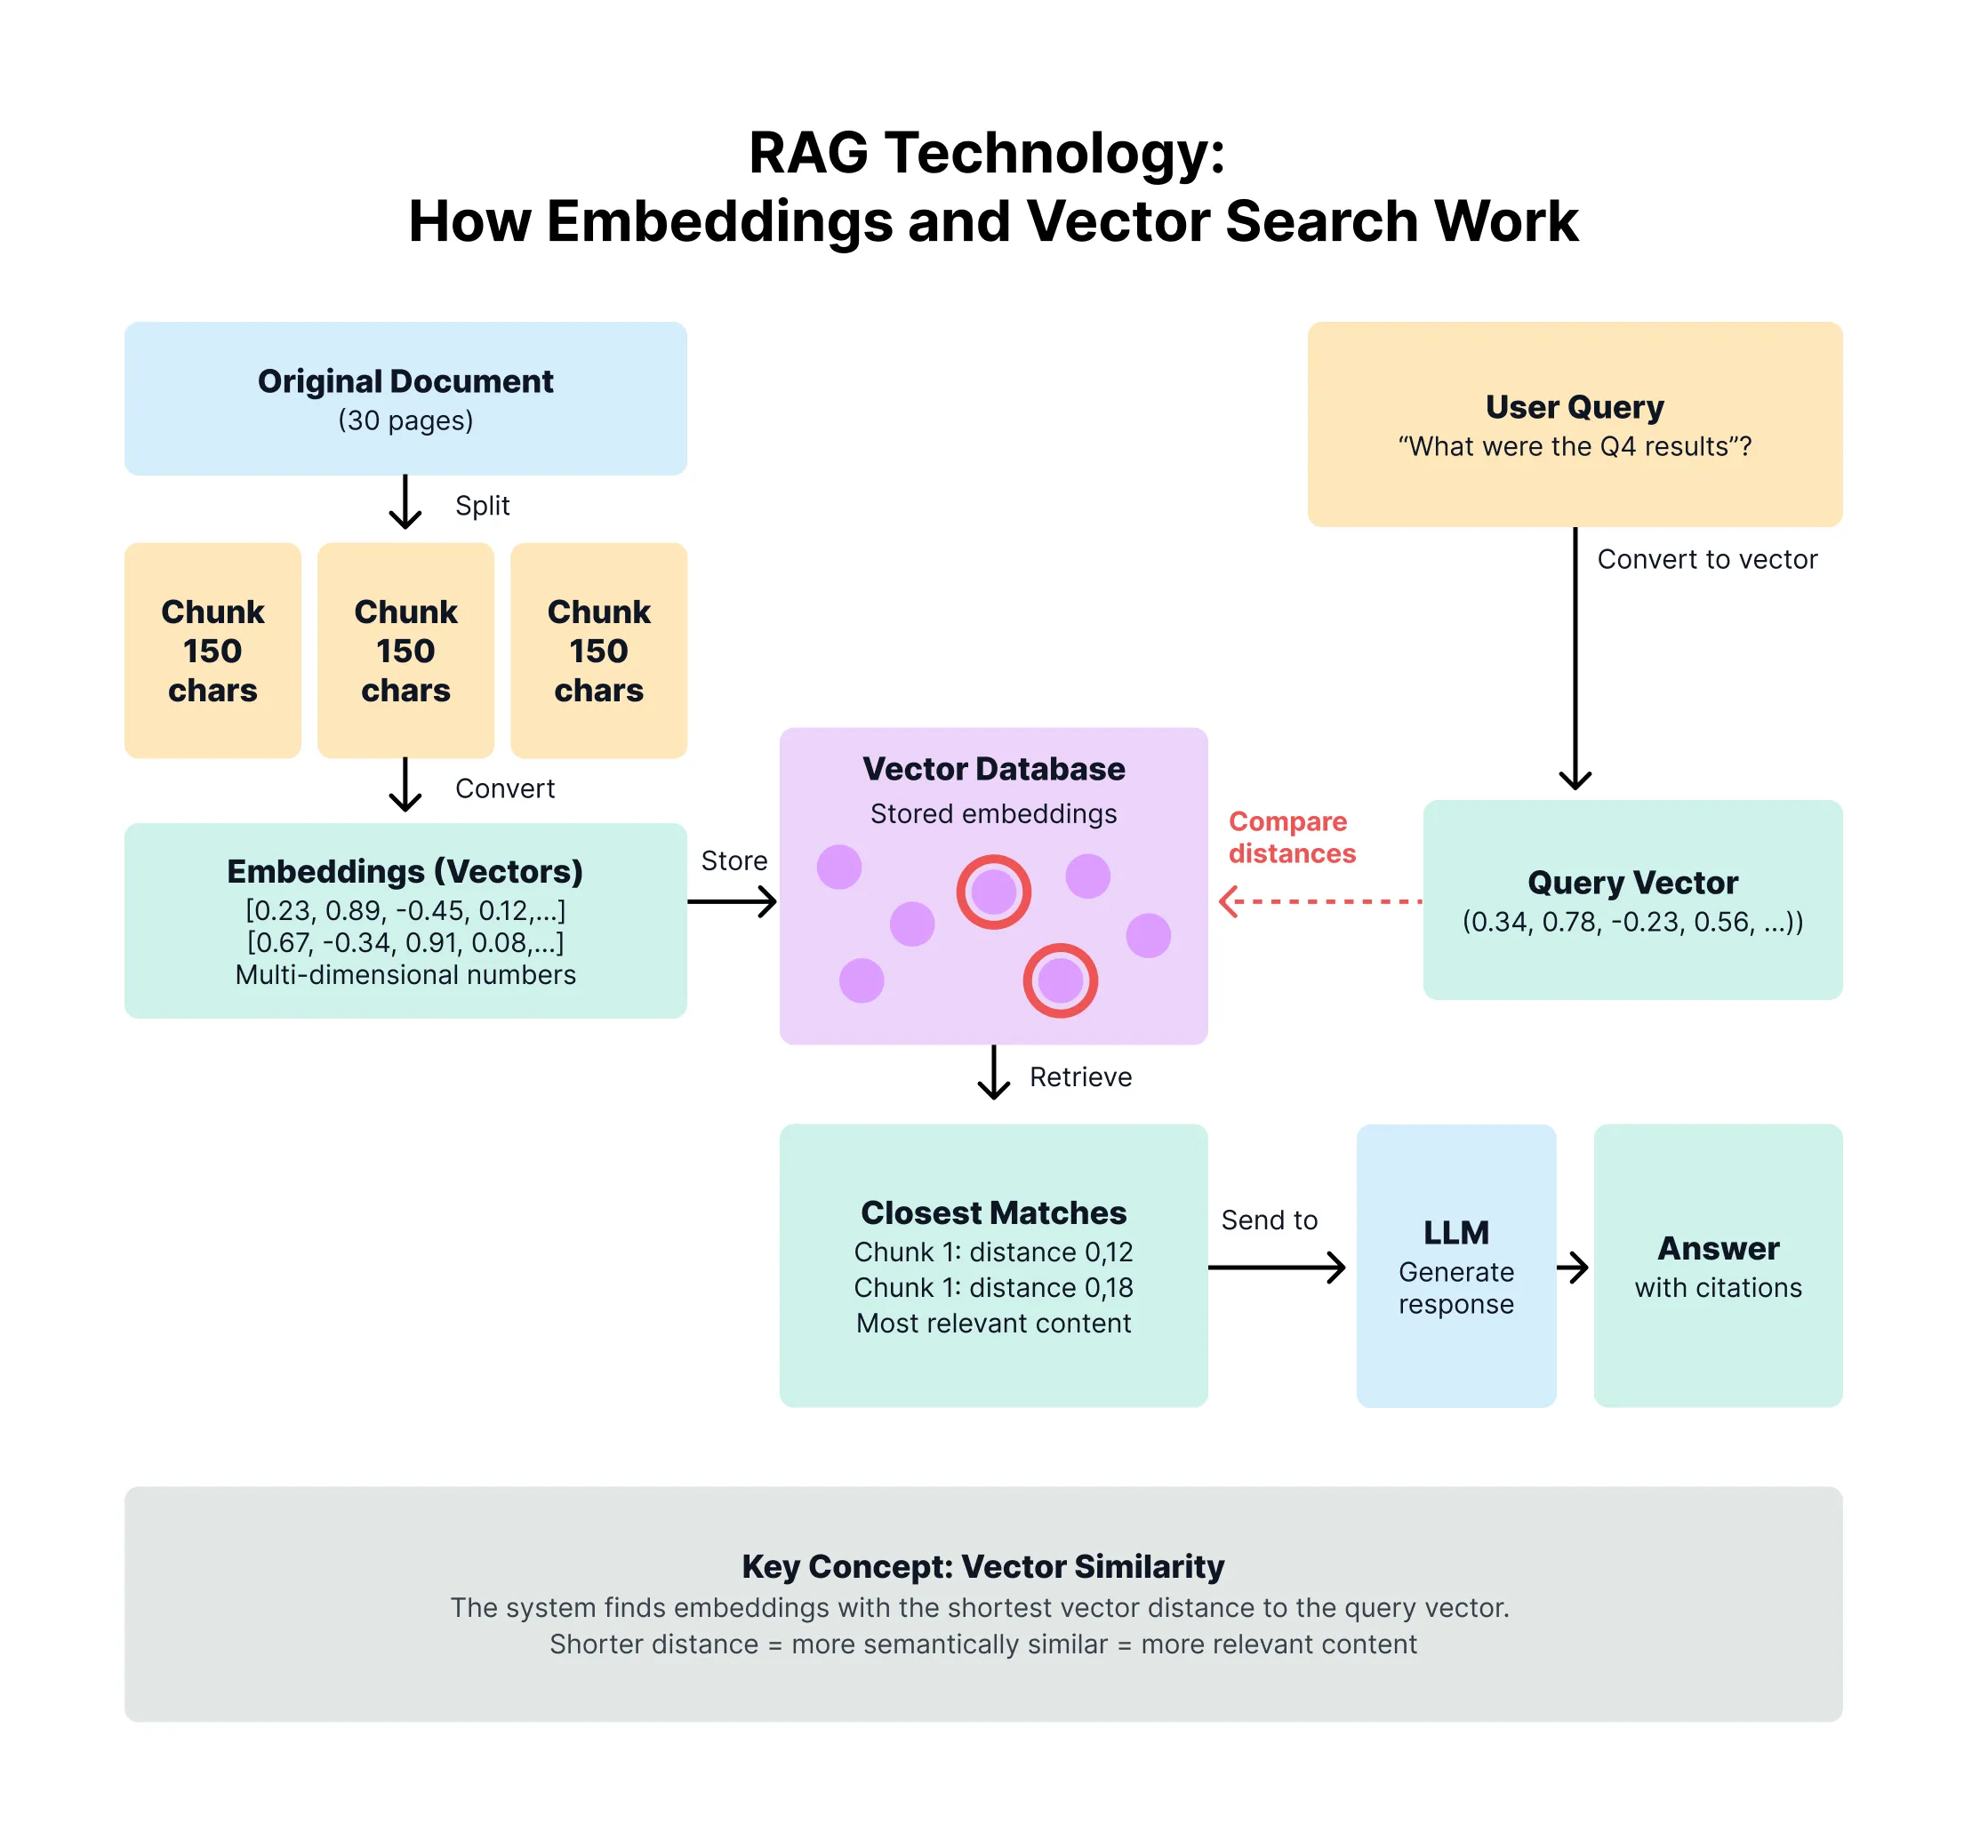
Je nach Anwendungsfall kann das System nur das Embedding zurückgeben, das vollständige Dokument, in dem es steht, oder mehrere Embeddings.
Warum RAG für Enterprise-KI zählt
RAG ist deshalb unverzichtbar geworden, weil es ein grundlegendes Problem löst: Große Sprachmodelle wissen nur, was in ihren Trainingsdaten stand, und diese Daten haben einen Stichtag. Laut AWS erweitert RAG die Fähigkeiten von LLMs auf bestimmte Fachgebiete oder die interne Wissensbasis eines Unternehmens, ohne dass das Modell neu trainiert werden muss.
Fragt man ein LLM nach aktuellen Ereignissen, nach internen Unternehmensdaten oder nach Spezialwissen, erzeugt es oft plausible, aber falsche Angaben, sogenannte Halluzinationen. IBM beschreibt, wie RAG dem begegnet: Es gibt KI-Systemen zum Zeitpunkt der Anfrage Zugriff auf aktuelles, fachspezifisches Wissen.
Ein Beispiel für RAG
Nehmen wir ein Pharmaunternehmen, das RAG für sein Forschungsteam einführt. Fragt eine Forscherin „Welche unerwünschten Ereignisse gab es in unserer Phase-2-Studie zu Wirkstoff XYZ-123?“, holt das System die zugehörige Studiendokumentation, die Zulassungsunterlagen und die Sicherheitsberichte heran. Das LLM erzeugt daraus eine belastbare Antwort, die auf den tatsächlichen Daten des Unternehmens beruht, samt Quellenangaben.
RAG: Stärken und Grenzen
Vorteile:
- hervorragend für unstrukturierte Texte - durchsucht Dokumente, PDFs und Berichte, an die SQL nicht herankommt
- Ähnlichkeitssuche über die Bedeutung - findet passende Informationen auch ohne exakte Stichwörter
- Quellenangaben - verweist auf konkrete Abschnitte eines Dokuments
- weniger Halluzinationen bei Textfragen - verankert Antworten in echten Dokumenten
Grenzen:
- funktioniert nur mit Text und Dokumenten - kann keine strukturierten Datenbanken abfragen
- hängt an der Qualität der Dokumente - Garbage in, garbage out
- die Qualität des Abrufs entscheidet - findet die Suche die falschen Dokumente, ist auch die Antwort falsch
- zusätzliche Latenz - der Abruf ist ein weiterer Schritt
- Risiken für die Governance - ohne saubere Kontrollen können unbefugte Daten sichtbar werden
Wichtig zu verstehen: RAG ist eigens für unstrukturierte Daten gemacht (Dokumente, Textdateien, PDFs, Berichte). Es ist eine spezialisierte Technologie für Texte, die sich mit klassischen Mitteln wie SQL nicht abfragen lassen.
Was ist ein Semantic Layer?
Ein Semantic Layer unterscheidet sich von RAG grundlegend in Reichweite und Zweck. Während RAG eine bestimmte Technologie für den Abruf unstrukturierter Texte ist, ist ein Semantic Layer ein breiterer Ansatz, um große Mengen an Informationen zu sammeln und zu ordnen, strukturierte wie unstrukturierte.
Ein Semantic Layer sitzt zwischen den rohen Datenquellen und den KI-Anwendungen und übersetzt technische Datenbankstrukturen in Begriffe, die im Geschäft verständlich sind. Laut Wikipedia überführt er Metadaten aus Datenquellen in einen unternehmensweiten semantischen Knowledge Graph.
Die Kernbausteine eines Semantic Layer
Ein moderner Semantic Layer verbindet in der Regel mehrere Technologien:
- Knowledge Graph - strukturierte Beziehungen zwischen Datenentitäten und Geschäftsbegriffen
- strukturierter Informationsspeicher - durchsuchbare Bestände an Geschäftsbegriffen, Definitionen und Metadaten
- Business Glossary - zentrale Definitionen, die für ein einheitliches Verständnis sorgen
- Metadatenspeicher - umfassende Angaben zu den Datenbeständen (technische, fachliche und betriebliche Metadaten)
Der Universalübersetzer für Daten
Stellen Sie sich einen Semantic Layer als Universalübersetzer für Ihre Daten vor. In Ihren Datenbanken stehen technische Feldnamen wie „cust_purch_amt_ytd“, die für die Technik Sinn ergeben und Fachbereiche ratlos zurücklassen. Der Semantic Layer bildet sie auf Geschäftsbegriffe wie „Einkaufsbetrag des Kunden im laufenden Jahr“ ab und sorgt dafür, dass „Umsatz“ in Vertrieb, Finanzen und Betrieb dasselbe bedeutet.
Für KI-Systeme ist der Semantic Layer noch wichtiger. Wenn ein KI-Agent Daten abfragen soll, muss er verstehen:
- was die Daten fachlich bedeuten
- wie verschiedene Kennzahlen zusammenhängen
- welche Definitionen verbindlich sind
- wie es um Lineage und Qualität der Daten steht
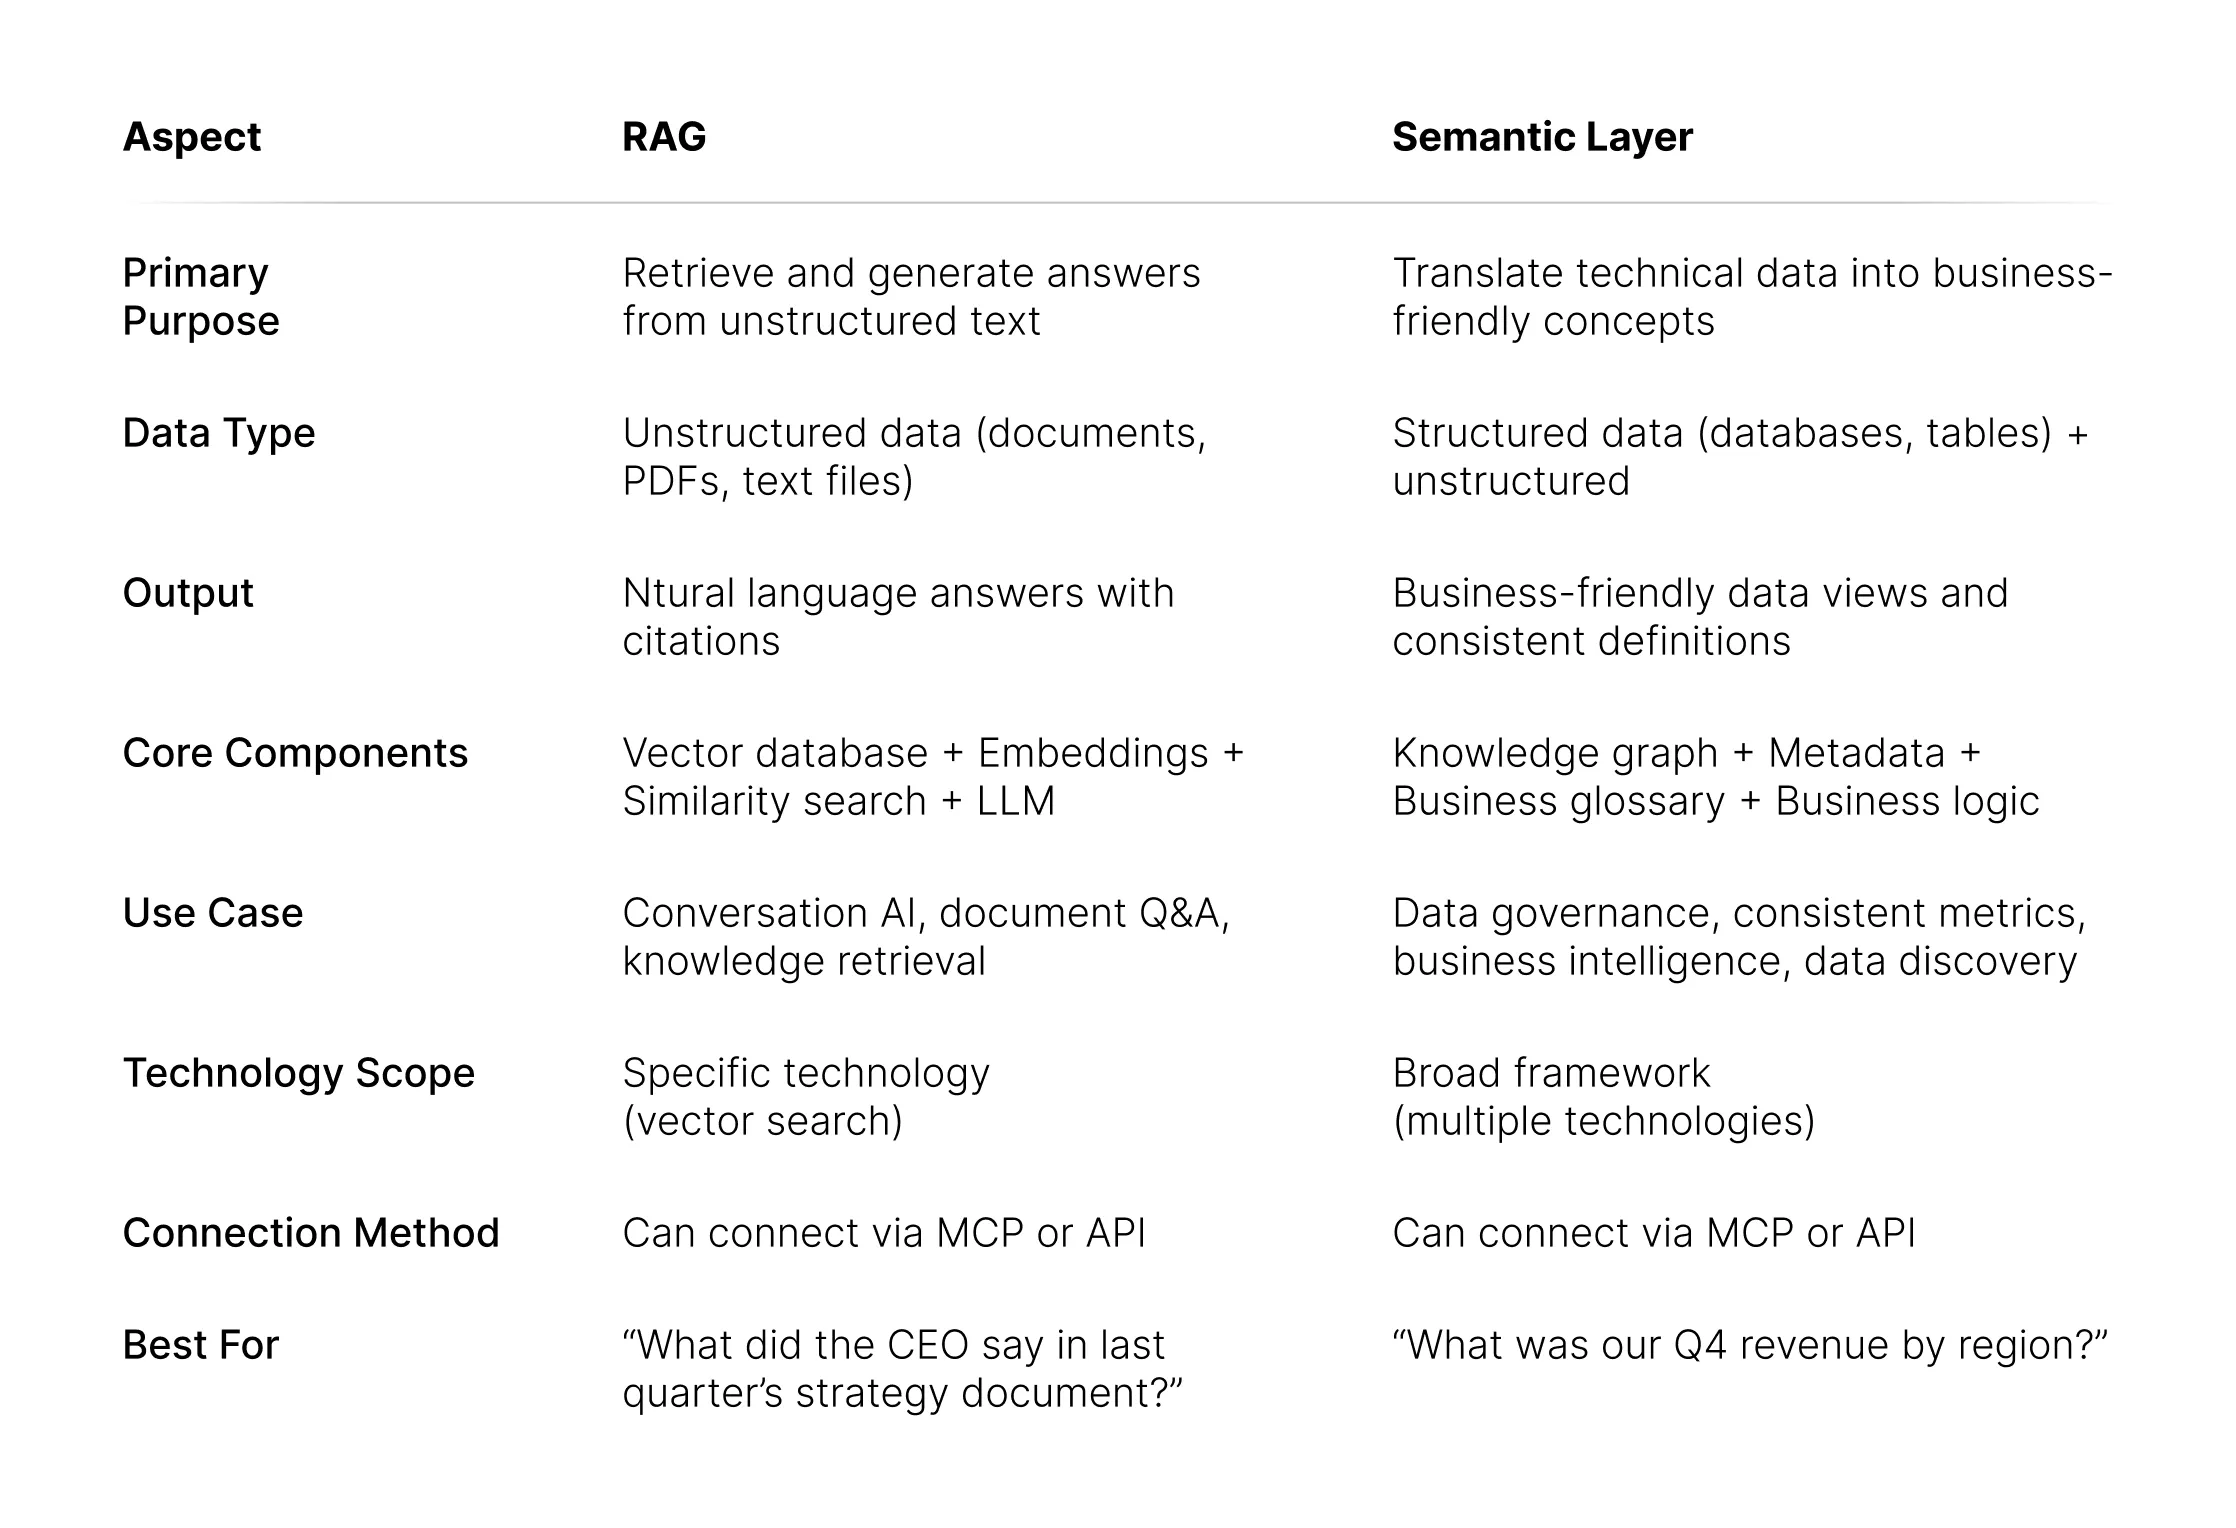
RAG vs. Semantic Layer: die zentralen Unterschiede
Die Unterschiede im Einzelnen
1. Art der Daten
RAG:
- arbeitet nur mit unstrukturierten Daten (Dokumente, Texte, PDFs)
- braucht Textinhalte, um Embeddings zu erzeugen
- nicht geeignet für Abfragen auf strukturierten Datenbanken oder für den Aufbau von fachlichem Kontext
Semantic Layer:
- verarbeitet strukturierte und unstrukturierte Daten
- beschreibt die Beziehungen strukturierter Daten über Knowledge Graphs
- erfasst Lineage und Beziehungen in strukturierten Daten
- kann die RAG-Technologie als einen Baustein einbinden
2. Anwendungsfälle
RAG:
- Dokumente suchen und abrufen
- Fragen aus Textquellen beantworten
- Abfragen auf einer Wissensbasis
- dialogorientierte KI auf Dokumentation
Semantic Layer:
- Business Intelligence und Analytik
- einheitliche Daten über das ganze Unternehmen hinweg
- Daten auffindbar machen und Governance sicherstellen
- KI-Agenten, die strukturierte Datenbanken abfragen
- umfassenden fachlichen Kontext aufbauen
3. Technologie oder Rahmenwerk
RAG ist eine bestimmte Technologie mit einer festgelegten Umsetzung: Vektordatenbank, Embeddings und Ähnlichkeitssuche.
Der Semantic Layer ist ein breiteres Rahmenwerk, das mehrere Technologien verbindet, um fachlichen Kontext zu liefern. Er kann RAG sogar als einen seiner Bausteine enthalten.
Das Verhältnis: ergänzend, nicht konkurrierend
RAG und Semantic Layer konkurrieren nicht miteinander. Wichtig ist: Beide Lösungen verfolgen unterschiedliche Zwecke und werden häufig zusammen eingesetzt.
Denken Sie an diese Fälle:
- nur RAG: Sie wollen interne Dokumentation, Richtlinien oder Forschungsarbeiten durchsuchen
- nur Semantic Layer: Sie wollen strukturierte Geschäftsdaten mit einheitlichen Definitionen abfragen
- beides zusammen: Sie wollen beantworten „Wie verhält sich unser Umsatz im vierten Quartal zu dem, was die Geschäftsführung im Strategieplan angesetzt hat?“ Dafür braucht es eine Abfrage strukturierter Daten und den Abruf von Dokumenten.
Moderne Enterprise-KI braucht oft beides. Nutzerinnen und Nutzer stellen Fragen, die Abfragen auf strukturierten Datenbanken und den Abruf unstrukturierter Dokumente zugleich umspannen. Der Semantic Layer kann sogar steuern, welche Dokumente überhaupt in RAG einfließen, gestützt auf Metadaten zu Verantwortlichkeit und Berechtigungen.
Das Wichtigste in Kürze
- Beide liefern Kontext - RAG und Semantic Layer sind Wege, KI-Systemen Kontext zu geben, und beide lassen sich über Protokolle wie MCP (Model Context Protocol) anbinden
- Die Art der Daten entscheidet - RAG für unstrukturierte Texte, der Semantic Layer für strukturierte Daten samt umfassendem fachlichem Kontext und ebenso für unstrukturierte Daten
- unterschiedliche Reichweite - RAG ist eine bestimmte Technologie, der Semantic Layer ein breiteres Rahmenwerk
- oft kombiniert - Enterprise-KI braucht beide häufig im Zusammenspiel
- keine Konkurrenten - sie lösen verschiedene Probleme und ergänzen einander
Wer diese Unterschiede kennt, kann KI-Systeme so entwerfen, dass sie genaue und belastbare Antworten liefern, indem sie die jeweils passenden Technologien verbinden.
Im nächsten Artikel sehen wir uns an, wie RAG und Semantic Layer in der Praxis zusammenspielen und wie moderne Lösungen für den Context Layer die Herausforderungen strukturierter und unstrukturierter Daten zugleich lösen.